
可控蛋白质序列设计:AI 让蛋白序列按需生成?
发布于 2026年10月25日
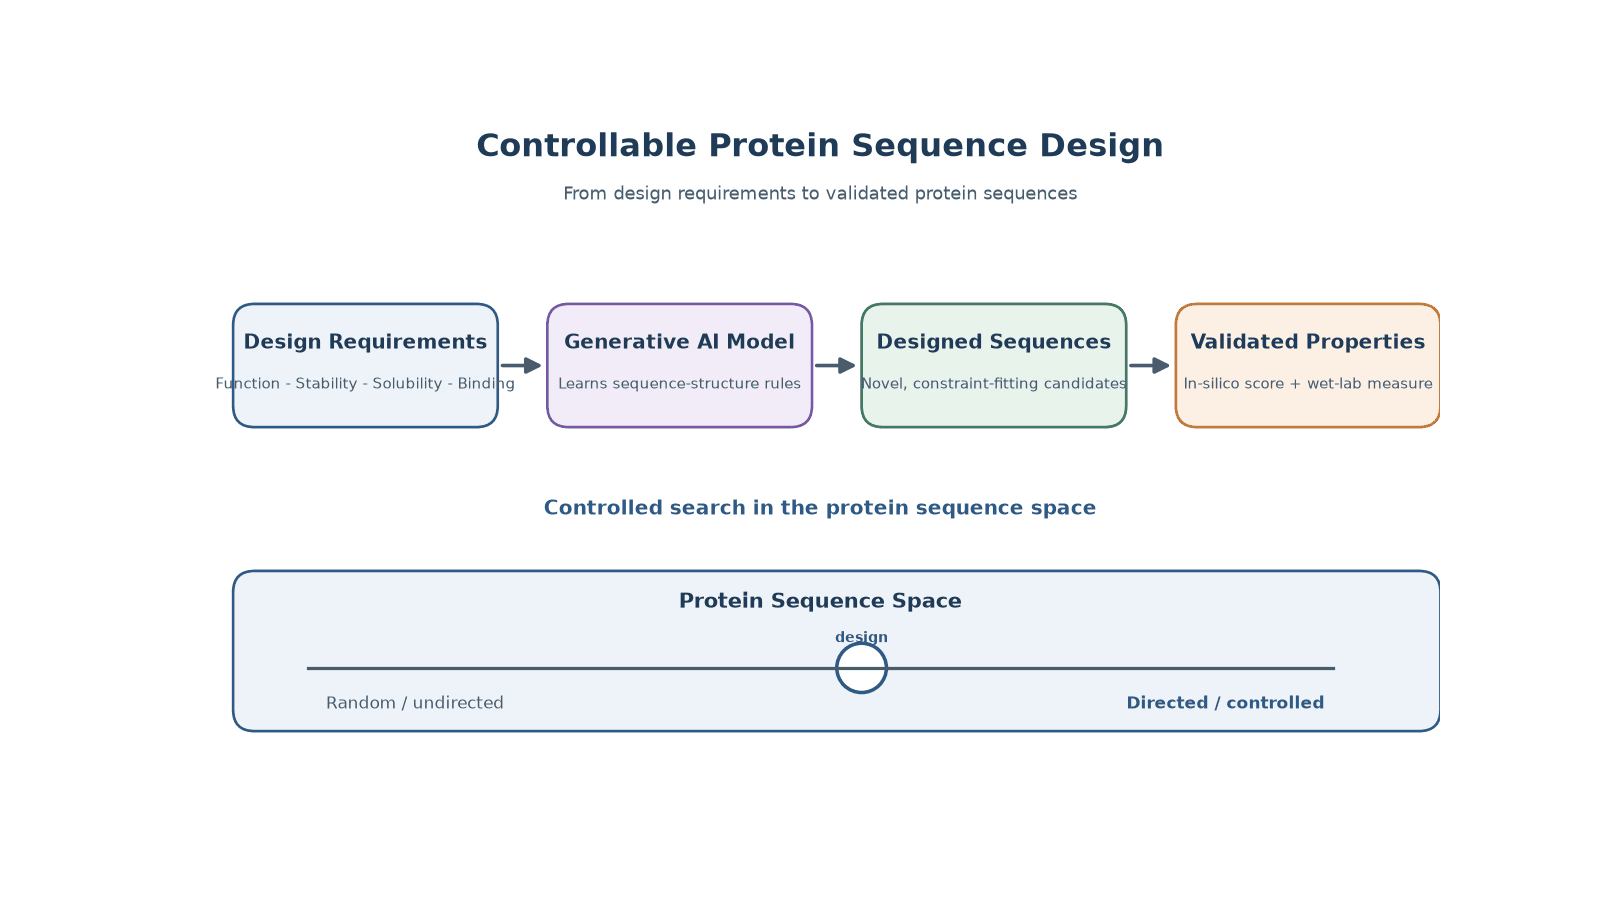
图1 可控蛋白质序列设计概念全景与关键流程
可控蛋白质序列设计:AI如何让蛋白序列「按需生成」?
蛋白是生命的「分子机器」,其功能由氨基酸序列决定。传统上,我们靠天然发现或定向进化「找」到合适序列;可控蛋白质序列设计则把主动权交给算法——给定一个目标,让AI在巨量序列空间里「设计」出满足条件的全新序列。这并非科幻,而是正在工业界落地的蛋白工程新范式。
背景与机制:为什么蛋白序列需要「可控」设计?
天然蛋白的序列由进化决定,活性、稳定性、溶解度等属性往往相互妥协;可控蛋白质序列设计把「找序列」变成「设计序列」,让研究人员按目标函数直接调控蛋白性质。
· 瓶颈:天然筛选与定向进化靠「突变+筛选」,周期以月到年计,且容易陷入局部最优。
· 难点:序列是「一维字符串」,功能却取决于三维折叠;序列-结构-功能映射复杂,单点突变常「牵一发而动全身」。
· 权衡:要活性更高、更耐热、更易溶、特异性更好,这些目标常常此消彼长。
· 可控设计:把需求写成约束或目标,用AI在巨大序列空间里定向搜索,而不是盲目突变。
序列空间的规模令人咋舌:一个100残基的蛋白,理论上可组合出20的100次方种序列,远超任何实验能覆盖的范围。正因如此,靠随机突变「大海捞针」效率极低,而可控设计把计算聚焦到真正有意义的区域。
· 结合生化经验:把已有的突变、结构与功能数据作为先验,能显著提升设计成功率。
类比:正如大模型能按主题与风格约束写出一段通顺文字,蛋白设计模型也能按结构或性质约束生成一条合理序列。
从这个角度看,可控蛋白质序列设计的本质,是把「进化」加速,并把「设计意图」前置到算法里。
原理与结构:可控蛋白质序列设计如何工作?
可控蛋白质序列设计的核心是「生成模型+条件控制」:模型先学习大量真实蛋白的序列与结构规律,再以结构模板、性质目标或进化信号为条件,解码出满足约束的全新序列。
· 生成模型:如基于Transformer、图神经网络或扩散模型的蛋白语言/折叠模型,学习「序列-结构」联合分布。
条件控制的三条路径:
· ①结构条件:给定主链骨架(backbone),设计能折叠成该结构的序列(逆向折叠inverse folding)。
· ②性质条件:以活性、稳定性、溶解度等目标作为引导(guidance / reward),让生成朝高适应度方向偏移。
· ③进化条件:以多重序列比对(MSA)或同源序列建模保守位点与残基协变,保留自然进化信息。
· 适应度景观(fitness landscape):把蛋白性质映射成「山丘与山谷」,模型在景观中寻找更高「山峰」。
· 能力边界:生成≠一定正确;模型对「没见过的」蛋白家族泛化性有限,必须用实验验证。
生成模型的输出并非「零到一」的凭空创造:它既可从已有蛋白结构出发做「逆向折叠」,也可在多序列同源信息上做「条件采样」。二者的差别在于约束的强弱——结构约束越强,生成越聚焦;性质目标越多,越需要多目标权衡。
· 主动学习(active learning):每轮实验数据回流,标记哪些序列更接近目标,让模型把下一轮生成集中在高信息量区域,减少无效尝试。

图2 条件控制如何引导模型生成目标序列
测定与选型:如何评价一段设计出来的序列?
一段设计序列是否可用,要拿「可预测+可实测」两把尺子衡量:先用计算评分粗筛(结构可行性、能量、物化性质),再通过湿实验测定活性、稳定性、表达与特异性等关键指标。
· 计算指标(in silico,预测):结构置信度(如pLDDT)、Rosetta能量/ΔΔG、溶解度与聚集倾向评分、可开发性。
· 实测指标(wet,实测):表达量、可溶性、热稳定性(Tm)、活性/催化效率、结合亲和力(KD)、特异性。
务必区分【预测】与【实测】:计算评分只是「筛选候选项」,只有湿实验数据才能对结果下结论。
· 按用途选型:工业酶催化偏重活性/稳定性;抗体偏重亲和力/可开发性;工业用蛋白偏重耐受与可生产性。
更完整的评价常按「漏斗」进行:先计算粗筛,再做高表达/可溶性初筛,随后功能测定,最后稳定性与可开发性验证;越靠后的测试成本越高、信息越关键,值得把预算优先放在这里。
· 数据透明:记录【预测】与【实测】的偏差,既是评估模型的手段,也是下一轮迭代的输入。
条件与工艺:从设计到拿到可验证候选物,关键参数有哪些?
从设计到可验证候选物,关键在于「干湿闭环」:设计-构建-测试-学习(DBTL)反复迭代,每一步都要有清晰的可行性与可重现参数,把计算方案与实验反馈对齐。
DBTL闭环流程:Define Target → Generate Sequences → Screen in silico → Test in wet lab → Learn →迭代。
· 候选规模:单批生成/筛选多少条序列;规模太大会浪费湿实验,太小覆盖面不足。
· 筛选阈值:哪些计算指标达标才进入湿实验,避免把预算花在低潜力序列上。
· 表达与纯化体系:宿主、载体、纯化方案要标准化,才能公平对比不同设计。
· 重复性与复现:同一设计应能重复出近似结果,否则无法判断模型是否有效。
成本与周期:把有限的湿实验聚焦到高潜候选,减少盲目试错。
· 数据回流:把湿实验实测值回填为训练/微调数据,模型才能逐步贴合真实系统。
· 质量控制:对表达、纯化、测定设置对照与重复,避免把系统误差误判为序列差异。
· 迭代轮次与预算:结合风险与周期,规划设计-验证的轮次与投入,避免无限循环。
成熟的干湿闭环通常需要多轮迭代:首轮设计先跑通「路径」,随后几轮聚焦「优化」,数据越多,模型越准。

图3 设计-构建-测试-学习(DBTL)闭环流程
MatwingsVenus®(晓鹜®)如何参与?
MatwingsVenus®(晓鹜®)把生成式设计与实验反馈串联成干湿闭环,让可控蛋白质序列设计不只是一段算法,而是一条能落到湿实验并交付候选物的路径。
· 设计(Dry):VenusREM单位点扫描、VenusPrime多点上位上效应建模、VenusX / VenusG功能残基与性质预测。
· 湿实验协同:推荐高潜力位点/组合供湿实验验证,实测数据回流更新模型。
· 干湿闭环平台:把计算建议与实验数据形成闭环,持续提升设计准确率。
· 适用场景:蛋白工程、酶改造、抗体设计、工业用蛋白等。
· 数据与可追溯:保留设计依据、预测分值与实验结论,便于复盘与复用。
例如,面对一个需要提升热稳定性的工业酶,平台可先基于结构做单位点与组合扫描,再用VenusX / VenusG预测稳定性与表达倾向,把「最值得做」的几十个候选交给湿实验;实测数据返回后,模型更新并进入下一轮,逐步逼近目标。
相关产品与服务:
· 湿实验:面向湿实验环节的产品与服务(链接:/zh/products/wet-lab)。
· 选型咨询:专家中心与选型咨询(链接:/zh/products/expert-center)。
· 闭环平台:干湿闭环平台(链接:/zh/dry-wet-closed-loop-platform)。
获取选型建议/提交样品/获取报价,请联系:电话13061973951,邮箱info@matwings.com。
常见问题(FAQ)
可控蛋白质序列设计和传统定向进化有什么区别?
可控蛋白质序列设计用生成式模型在约束下定向生成多候选,而定向进化靠随机突变与筛选逐步逼近,前者能更快覆盖更大序列空间。
生成出来的序列一定能在实验室里成功表达吗?
不一定。计算生成的序列可能无法折叠或表达,必须经计算粗筛与湿实验验证后才能确认可用。
可控蛋白质序列设计能提高热稳定性吗?
可以。把热稳定性作为约束或目标加入模型,通常能提高序列耐热性,但仍需实测Tm等指标确认。
这个技术适用于哪些蛋白?
适用于酶、抗体、工业用蛋白等各类蛋白,但模型泛化性受训练数据覆盖影响,陌生蛋白家族效果有限。
使用这个技术需要提供哪些输入?
通常需要目标蛋白的序列、结构(PDB / AlphaFold模型)或关键性质目标,输入越明确,设计越聚焦。
AI生成的序列会带来安全风险吗?
模型输出需经人工安全审查,避免引入毒性、病原性或监管敏感序列,这是可控设计必须遵守的边界。
如何开始使用MatwingsVenus®(晓鹜®)?
可先提交需求或样品,获取设计/筛选方案,再由平台与湿实验联合验证、迭代,形成候选交付。
总结
可控蛋白质序列设计正在把蛋白工程从「碰运气」变成「按计划设计」。它的价值不在于替代实验,而在于让每一次湿实验都花在更有可能成功的候选上。未来,随着数据与模型的持续积累,这条「设计-验证-学习」的闭环会越来越准、越来越快。
