
新闻公告

海洋微生物酶挖掘:如何从深海发现下一个工业酶?
海洋微生物酶挖掘:从深海、近海与极地微生物中系统地发现蛋白酶、脂肪酶、糖苷酶等生物催化剂。本文梳理海洋微生物酶的多样性(盐耐受、冷适应、嗜压等栖息地相关特性),详述「宏基因组挖掘+活性筛选+序列挖掘」两条技术路径,以及冷适应与嗜盐酶的分子机制;给出海洋酶从样本采集、筛选验证到发酵放大与下游纯化的工业化工艺,并说明MatwingsVenus®(晓鹜®)「干湿闭环」如何加速海洋酶的发现与改造。可摘录结论:海洋微生物是当前多样性最高的天然酶库,海洋酶挖掘的关键在于「样本—筛选—进化—放大」的闭环与产业化放大能力。
2026年10月26日
蛋白质骨架设计是什么?——让蛋白的“骨架”决定功能、稳定与可开发性
蛋白质骨架设计(Protein Scaffold Design)是蛋白工程的核心环节:在保留或重塑蛋白三维结构“骨架”的前提下,通过计算设计与湿实验验证的闭环,提升稳定性、活性与可开发性。
2026年10月26日
什么是功能约束蛋白质设计?它如何让AI设计出真正能用的蛋白?
功能约束蛋白质设计(function-constrained protein design)指把目标功能——如结合亲和力、催化活性、特异性、可溶性、稳定性与表达量——作为硬性约束嵌入蛋白质序列/结构设计流程,让「功能是否达标」成为设计的最终判据。与只求结构合理的「结构设计」不同,它综合蛋白语言模型、适应度景观与活性学习,通过「计算设计→湿实验验证→数据回流」的干湿闭环持续逼近最优方案。本文解析其核心原理、关键约束维度、测定指标与落地工艺,并介绍MatwingsVenus®(晓鹜®)如何把这一方法工程化。
2026年10月26日
饲用黄曲霉毒素分解酶:从AFB1降解机理到饲料酶法脱毒的选型与工艺控制
饲用黄曲霉毒素分解酶通过氧化、还原、水解等机制降解饲料中黄曲霉毒素B1;掌握降解机理、活性测定与pH/温度/酶底比控制,是酶法脱毒稳定落地的前提。
2026年10月26日
土壤宏基因组酶挖掘:如何从土壤微生物组中发现新酶?
土壤宏基因组酶挖掘;活性筛选与序列挖掘双路线;AI 预测+湿实验闭环加速新酶发现。把功能筛选与序列挖掘相结合,土壤宏基因组酶挖掘正成为从「不可培养微生物」中高效获取工业酶的关键路径。
2026年10月25日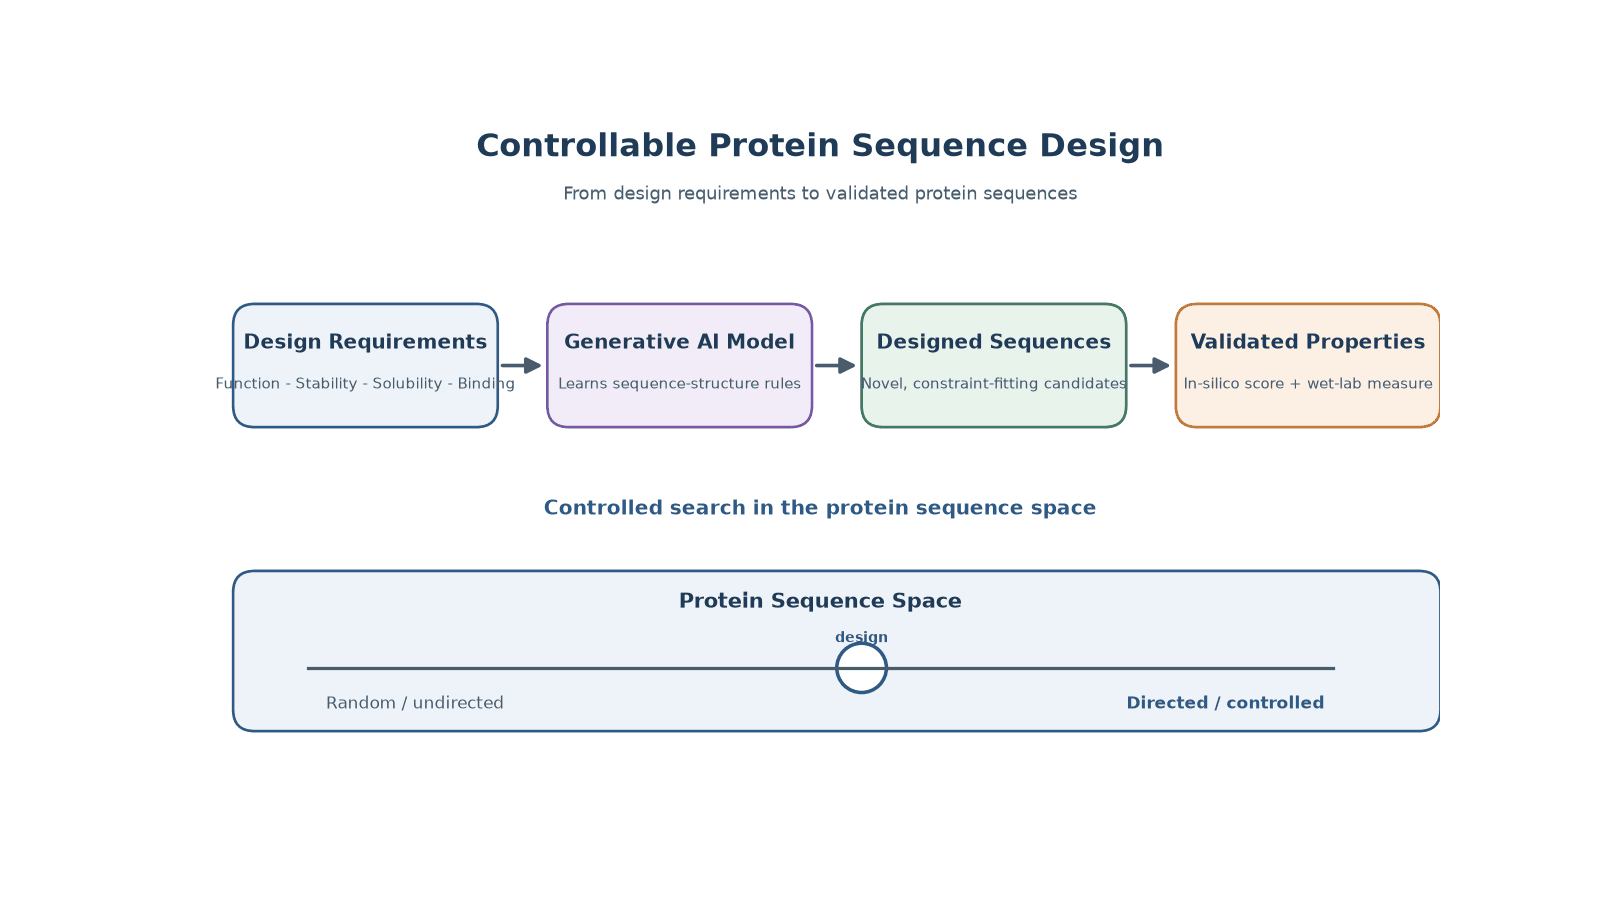
可控蛋白质序列设计:AI 让蛋白序列按需生成?
可控蛋白质序列设计是利用生成式 AI,在功能、稳定性、溶解度或结合亲和力等约束下设计全新蛋白序列的技术。它把「从结构找序列」升级为「按需求设计序列」,通过条件控制、适应度景观与主动学习闭环,快速产出可验证候选物。
2026年10月25日
抗菌肽如何兼顾杀菌与安全?从膜破坏机理到序列设计与工程化选型指南
抗菌肽是阳离子两亲性短肽,通过吸附并破坏细菌膜杀菌,但选择性、稳定性与量产成本决定工程化成败;评价须联动最低抑菌浓度与安全性指标,而非只看单一MIC。
2026年10月25日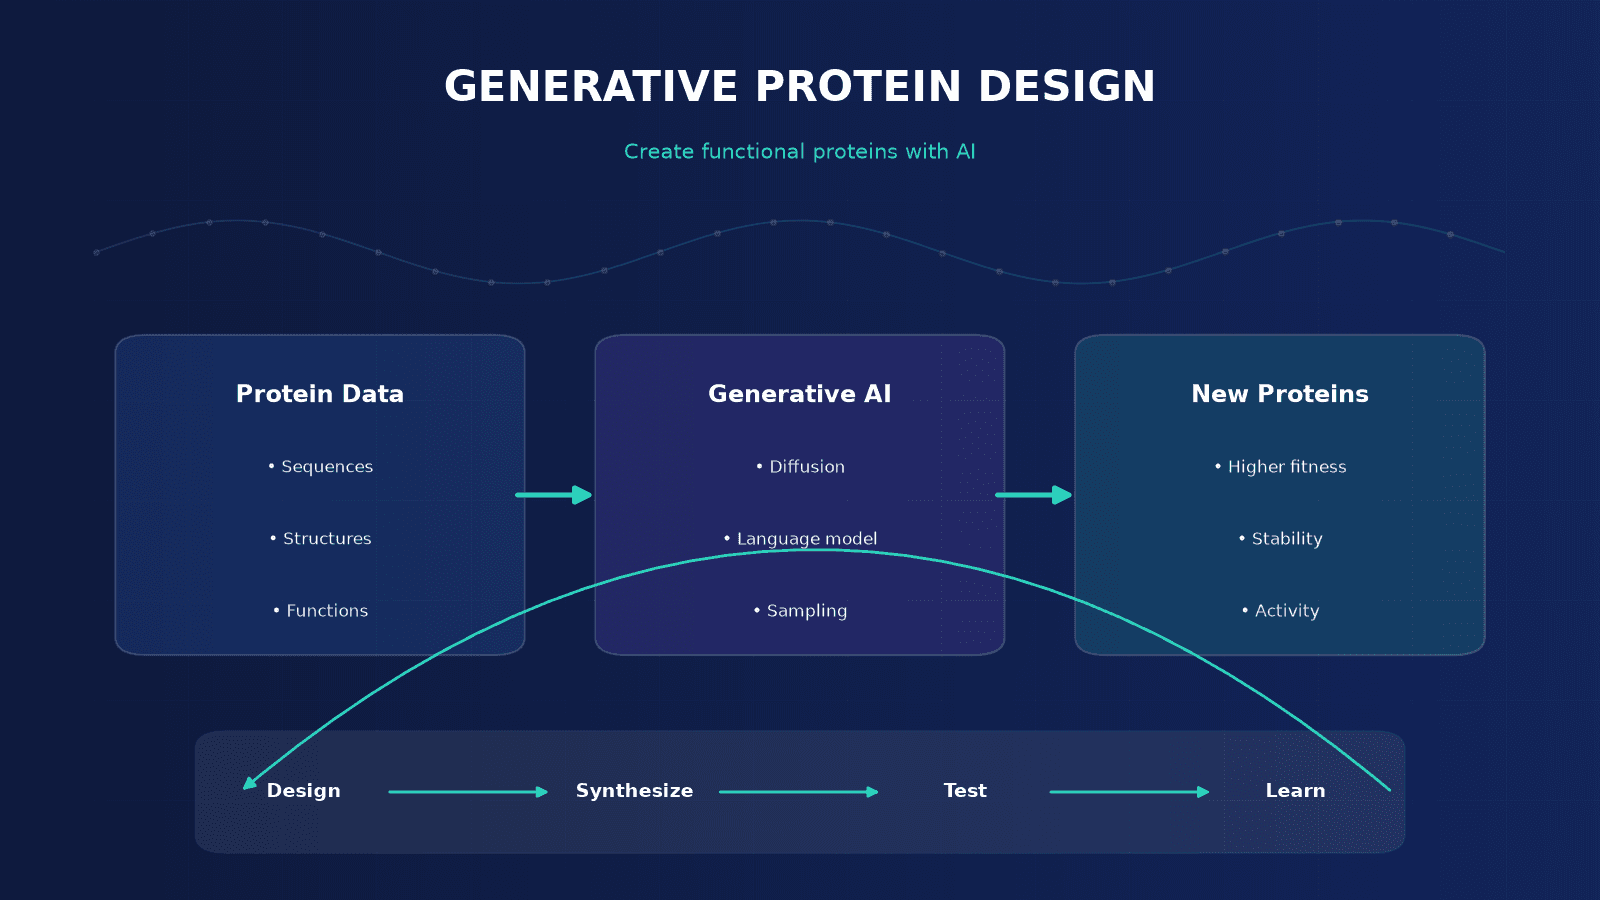
生成式蛋白质设计如何从根本上重塑蛋白质改造?
生成式蛋白质设计(Generative Protein Design)是一种用机器学习模型"从零创造"或系统性改造蛋白质的方法:它不是简单替换氨基酸,而是通过学习海量序列与结构数据,生成具有目标功能(如更强活性、更高稳定性、更好可分泌性)的全新蛋白候选。相比传统定向进化依赖大量随机突变与湿实验筛选,生成式方法能显著扩大搜索空间、减少实验轮次,把湿实验用在更可能成功的候选上。本文梳理其核心机制、验证路径与干湿闭环工艺,并说明MatwingsVenus®(晓鹜®)如何以"AI生成+湿实验反馈"的闭环赋能蛋白研发。
2026年10月25日
极端微生物酶挖掘:从极端环境如何筛出工业级酶?
本文围绕「极端微生物酶挖掘」这一主题,系统讲解极端微生物与极端酶的定义、极端酶的分子稳定机制、测定筛选策略与工业化工艺流程,并结合MatwingsVenus®(晓鹜®)在湿实验、专家中心与干湿闭环平台上的能力,说明如何把极端环境中的酶资源转化为工业级生物催化剂。
2026年10月25日
溶菌酶真的能裂解所有细菌吗?从肽聚糖切割机理到工业细胞裂解的选型与工艺指南
溶菌酶专攻细菌细胞壁肽聚糖的β-1,4糖苷键,对革兰氏阳性菌高效、对革兰氏阴性菌需先破除外膜;把类型、比活与真实裂解效率联动评价,才是稳定的细胞裂解工艺。
2026年10月25日
胃蛋白酶:从酸性天冬氨酸蛋白酶机理到酶解工艺的选型与控制指南
胃蛋白酶是酸性天冬氨酸蛋白酶的代表,在强酸条件下依赖催化双联体实现特异性肽键水解;吃透其底物偏好与控参逻辑,是酶解工艺稳定投产的前提。胃蛋白酶是典型天冬氨酸蛋白酶,最适pH 1.5–2.5、偏好切割疏水残基侧肽键。本文从催化机理讲起,覆盖活性检测(血红蛋白/Anson法)与pH、温度、酶底比、终止策略等工艺要点,并给出工业选型与「晓鹜商城」重组工具酶(Kex2、肠激酶/3C、羧肽酶B)、蛋白定制改造的完整方案,助您让酶解工艺稳定投产、用得当。
2026年10月25日
糖活性酶挖掘:如何从宏基因组中「淘」到高价值碳水化合物活性酶(CAZyme)?
糖活性酶挖掘(carbohydrate-active enzyme mining)是从土壤、热泉、海洋等环境宏基因组中,通过序列比对、结构搜索与人工智能算法,系统发掘糖苷水解酶(GH)与糖基转移酶(GT)等碳水活性酶(CAZyme)的技术路径。本文梳理糖活性酶挖掘的背景、原理、测定筛选与发酵工艺,并介绍天鹜科技 MatwingsVenus®(晓鹜®) 如何以「干湿闭环」平台加速从基因到工业用酶的转化,适用于食品、饲料、纺织与医药等场景。
2026年10月25日
宏基因组新酶筛选方法:从环境基因库到工业新酶
宏基因组新酶筛选方法;宏基因组新酶筛选流程;功能筛选;序列筛选;AI辅助新酶发现;高通量筛选。理解宏基因组新酶筛选的核心原理、两条主流路径与关键工艺参数,并借助AI赋能与干湿结合平台加速从环境基因库到工业新酶的落地。
2026年10月25日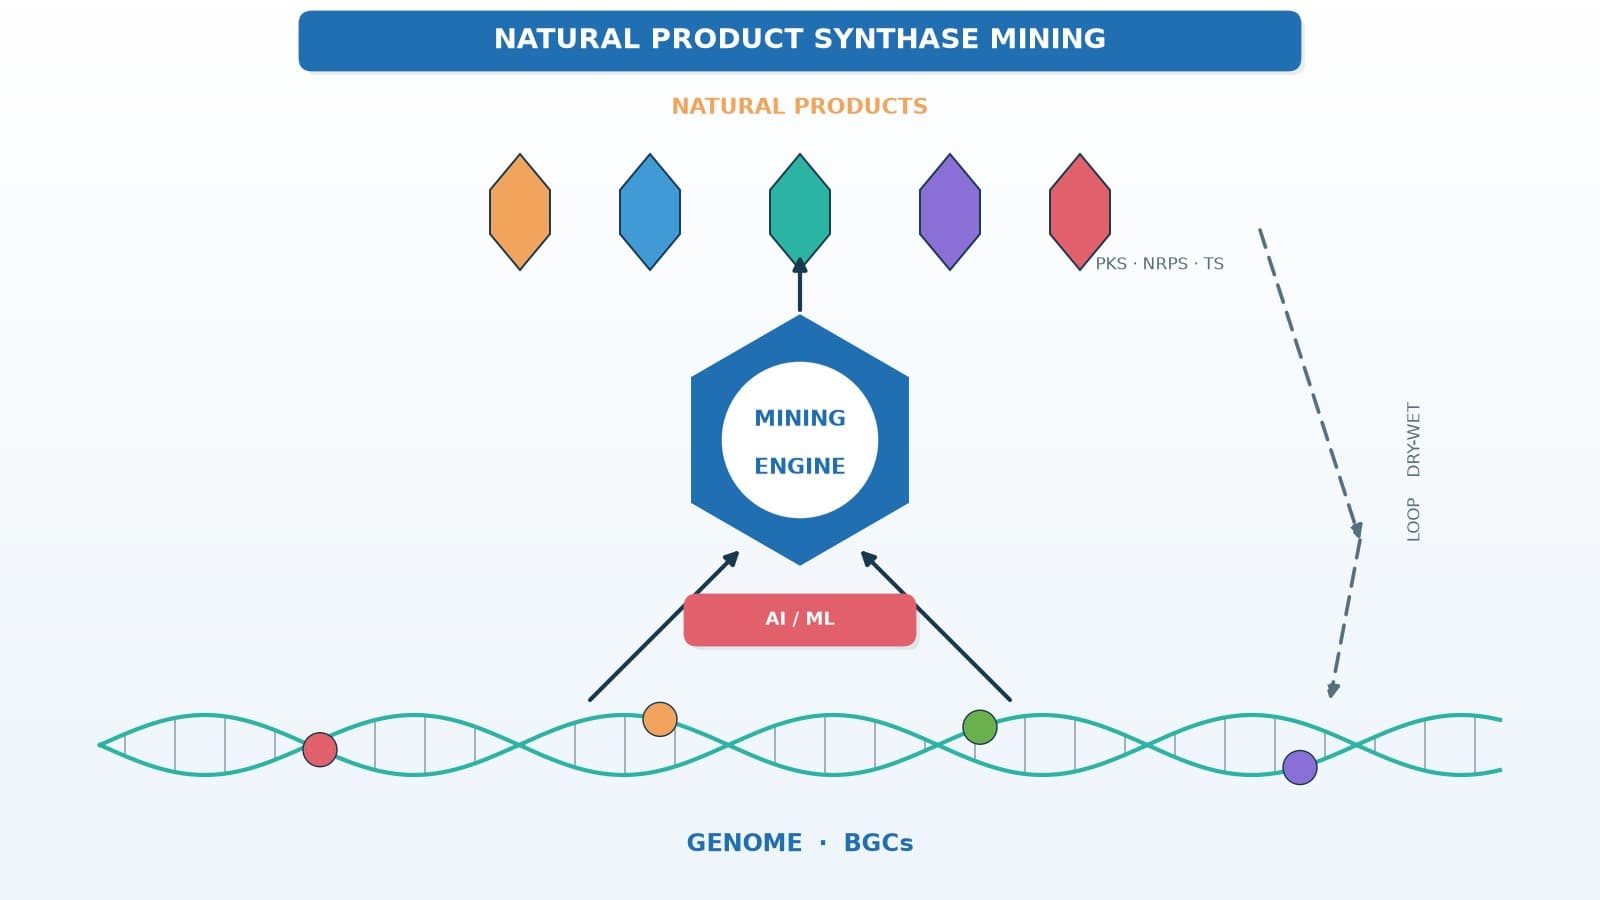
天然产物合成酶挖掘:如何从基因组中系统搜索「药物工厂」?
天然产物合成酶挖掘(natural product synthase mining)是指利用基因组测序、生物信息学与人工智能,系统定位并鉴定能合成聚酮、非核糖体肽、萜类等天然产物的生物合成基因簇与关键合成酶。
2026年10月22日
新型酶发现方法:序列、结构与AI高效挖掘
新型酶发现方法已从依赖可培养微生物的“机会性筛选”,演变为把宏基因组、序列/结构挖掘与AI功能预测串成系统化闭环的工程方法,从而更快、更广、更可控地供给适用工业的催化剂。
2026年10月22日
植酸酶是如何"拆开"植物饲料里的磷?从机制到工艺再到选型
植酸酶通过水解植酸释放无机磷,是提升饲料磷利用率与环保降排的关键酶。本文解析其作用机制、分类及在饲料制粒中的应用场景与工艺控制。并介绍MatwingsVenus®(晓鹭®)AI蛋白设计与干湿闭环平台如何助力植酸酶的活性、热稳定性及底物特异性改造,加速从计算筛选到工艺放大落地。
2026年10月22日
极端环境酶挖掘:为什么极端生境是下一代工业酶的宝库?
极端环境酶挖掘正成为工业酶研发的前沿方向。高温、极寒、高盐、高压等极端生境中生存的微生物,孕育出结构更稳定、功能更独特的极端酶。本文解析极端酶的热稳定、冷适应与耐盐分子机制,梳理培养依赖、宏基因组与AI序列/结构挖掘三条发现路径,以及表达、改造与工艺放大的工程化流程,并结合MatwingsVenus®(晓鹜®)干湿闭环AI平台,探讨如何加速极端环境酶的发现、改造与产业化落地。
2026年10月22日
酶挖掘系统发育树分析:如何用进化图谱系统筛选高价值新酶?
系统发育树分析通过重建同源酶的进化关系,在湿实验前把筛酶工作从「逐个试」压缩为「按分支挑」,是天然酶挖掘的通用前置方法。酶挖掘系统发育树分析把「找相似」升级为「看进化」,让研究者在湿实验前完成候选酶的「减量」与「定向」,从而降低筛选成本、提高命中率。
2026年10月22日
胰蛋白酶如何精准切割肽键?丝氨酸蛋白酶机制、选型与工艺控制
胰蛋白酶(trypsin,EC 3.4.21.4)是由胰腺以无活性胰蛋白酶原形式分泌、进入十二指肠后被肠激酶激活的丝氨酸内肽酶,其催化核心为高度保守的催化三联体(His-57 / Asp-102 / Ser-195),通过氧负离子洞稳定过渡态,并由S1口袋内的Asp-189特异性识别赖氨酸(Lys)与精氨酸(Arg)侧链,从而实现对碱性残基后肽键的精准切割。本文梳理了胰蛋白酶的生理激活路径(胰蛋白酶原→肠激酶切割DDDDK →活性胰蛋白酶)、活性测定方法(BAEE / TAME酯酶活力)、选型维度(动物源vs重组、纯度、非特异切割率、内毒素、AOF合规)与酶解工艺控制要点(pH 7.5–8.5、37 °C、Ca2+稳定与抑制自溶、PMSF/TLCK/aprotinin等终止手段),并说明其在细胞培养传代消化、LC-MS/MS蛋白质组学肽段制备及生物制药中的应用。最后介绍MatwingsVenus®(晓鹜®)如何以"湿实验+专家中心+干湿闭环平台"组合,为胰蛋白酶的选型、活性验证与工艺优化提供数据驱动的支持。
2026年10月22日%20in%20environmental%20DNA%2C%20to%20complete%20gene%20boundaries%20(Gene%20boundary)%20and%20genomic%20context%20(Gen.jpg&w=3840&q=75)
环境微生物酶挖掘:如何从环境DNA中找到真正可表达、可催化的天然酶?
环境微生物酶挖掘把环境DNA中的候选开放阅读框转化为边界清楚、可表达、可催化的天然酶。可靠的挖掘先确认基因边界与ORF完整性,再借基因组上下文、同源与结构挖掘(VenusMine)扩大候选,由序列驱动与功能驱动互补;候选经VenusG评估排序后,用异源表达与活性测定确认功能。遵循Search Before Mining,把预测与实验验证区分开,让每个候选回到可验证、可复用的证据链上。
2026年10月22日
酶挖掘保守位点分析:为什么它是找到酶催化机器的入口?
酶挖掘保守位点分析;保守位点通过进化保持性指向酶的催化机器,为定向进化与功能注释提供可验证的靶点。
2026年10月22日
角蛋白酶(Keratinase)是什么?它如何“啃”动最硬的角蛋白?
角蛋白酶(Keratinase)是一类能特异性地催化降解角蛋白(Keratin)的蛋白酶。角蛋白是羽毛、毛发、蹄甲、皮毛等生物质中的核心结构蛋白,富含β-折叠与密集的二硫键,天然非常顽固难降解;而角蛋白酶正是解开这一“结构堡垒”的关键工具,因此在羽毛资源化、皮革脱毛、饲料蛋白、日化与洗涤等领域受到广泛关注。
2026年10月22日
功能酶筛选:如何在百万突变体里,找到那台“高效发动机”?
功能酶筛选(functional enzyme screening)是把“基因型”和“表型”一一对应、从庞大突变文库中挑出高性能酶的关键技术。传统微孔板、色谱、质谱每天只能筛几百到几千个突变体;借助荧光激活细胞分选(FACS)与液滴微流控(FADS)等单细胞区室化手段,通量可提升到 10⁷–10⁸/天,试剂消耗下降约百万倍。本文梳理其机制、测定与选型、工艺要点,并介绍 AI 驱动、干湿闭环如何让筛选更好、更快、更省。
2026年10月21日
新酶发现:先定义什么才算真正的新酶证据
新酶发现的关键不是“数据库里没见过”,而是先明确要证明哪一种“新”,再据此匹配检索、排序与验证证据。本文拆解序列、结构、反应、应用四类新颖性,说明“降低相似度阈值≠找到新酶”,并厘清自然发现与蛋白改造的分界;再结合 MatwingsVenus®(晓鹜®)的 Search Before Mining 工作流,给出可执行的新酶发现路径与常见问题(FAQ),帮助研发团队把“新颖性”转化为真正可用的酶资源。
2026年10月21日
目标反应酶怎么筛选:从候选发现到实验验证
研发人员搜索“目标反应酶怎么筛选”,真正需要的不是一串数据库名称,而是一条把反应需求、已知证据、候选排序与实验验证连接起来的可执行路径。本文先定义反应规格,再用“数据库—序列—结构”三层证据建立候选池,按多目标取舍排序,并通过对话式智能工作流把计算筛选与湿实验验证连成闭环,帮助团队减少盲目试错、保留改造依据。
2026年10月21日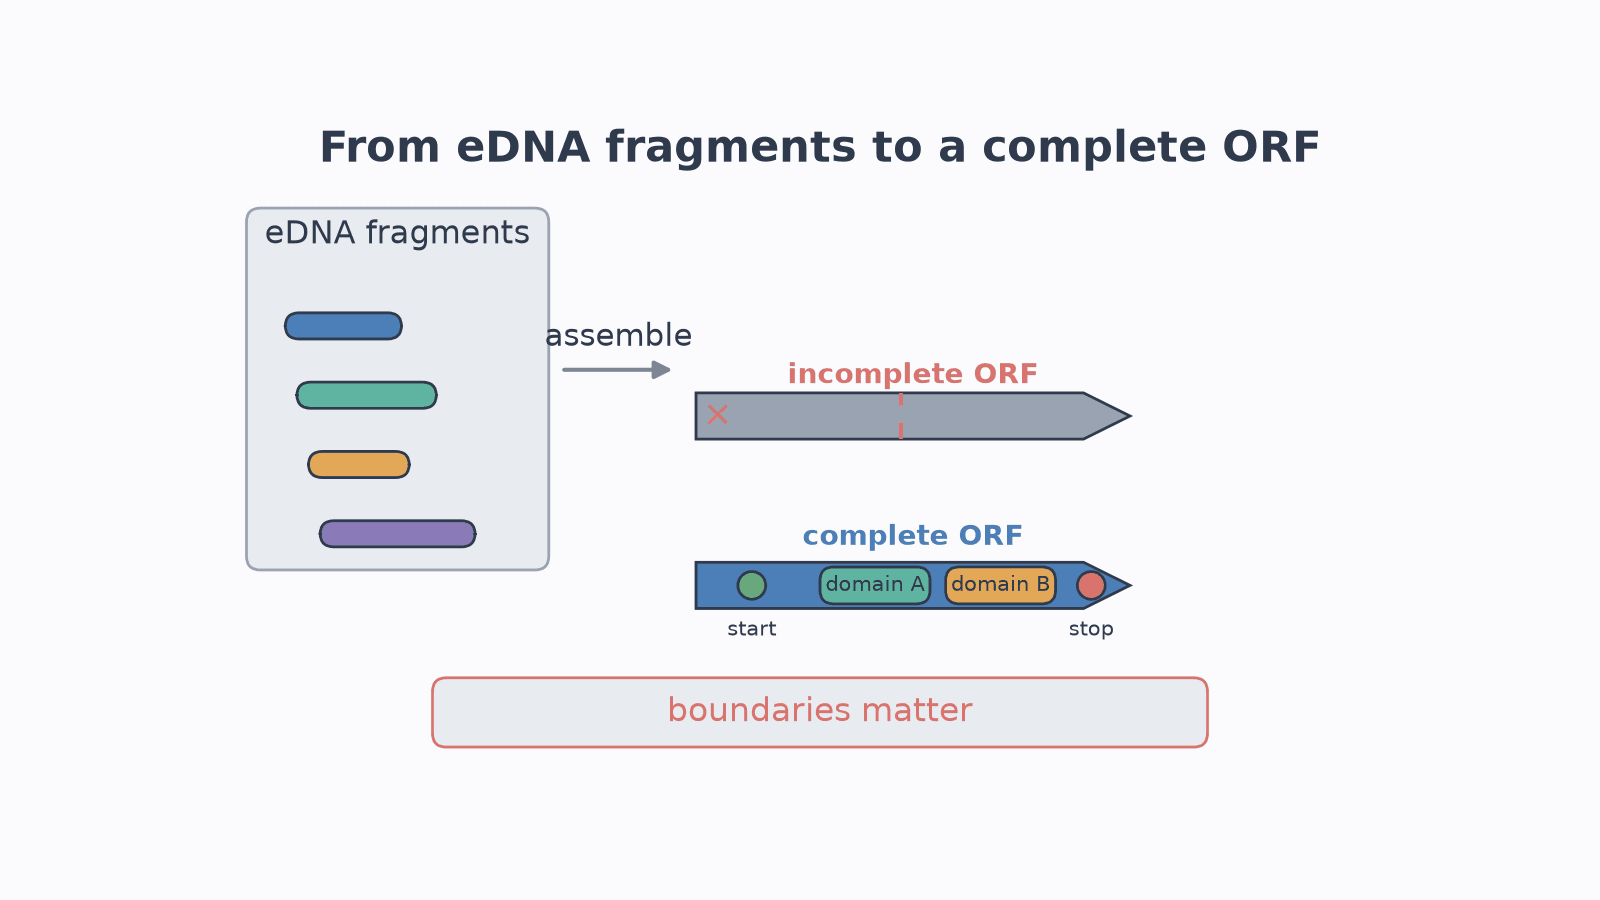
酶基因挖掘,关键不只在找到同源序列
酶基因挖掘是从环境DNA中寻找可表达、可催化的天然酶的过程。本文梳理宏基因组酶挖掘的关键环节:先确认开放阅读框(ORF)边界完整,再借助基因组上下文、保守结构域与同源证据交叉验证;理解序列驱动与功能宏基因组学两条路线的取舍,以及异源表达与催化验证如何把候选基因连到真实功能。最后介绍MatwingsVenus®(晓鹜®)在蛋白层面的发现与排序能力。适合酶工程与微生物生物技术从业者阅读。
2026年10月21日
酶挖掘完整流程:如何缩短候选验证路径?
工业酶的真正瓶颈并非缺少序列,而是“候选太多、验证太慢、数据难衔接”。本文系统梳理酶挖掘完整流程:从把产业目标写成可验证约束,到策展数据库与宏基因组检索、序列与结构双路径扩展,再到多维计算筛选与 Pareto 多目标保留,最后经湿实验验证并把结果回流到下一轮。结合 UniProt、InterPro、PDB、AlphaFold、MGnify 等权威资源与 BLAST、Foldseek 检索策略,说明如何通过逐层收敛与实验反馈,把海量候选压缩为少数值得测试的序列,从而减少无效合成、缩短候选验证路径。
2026年10月21日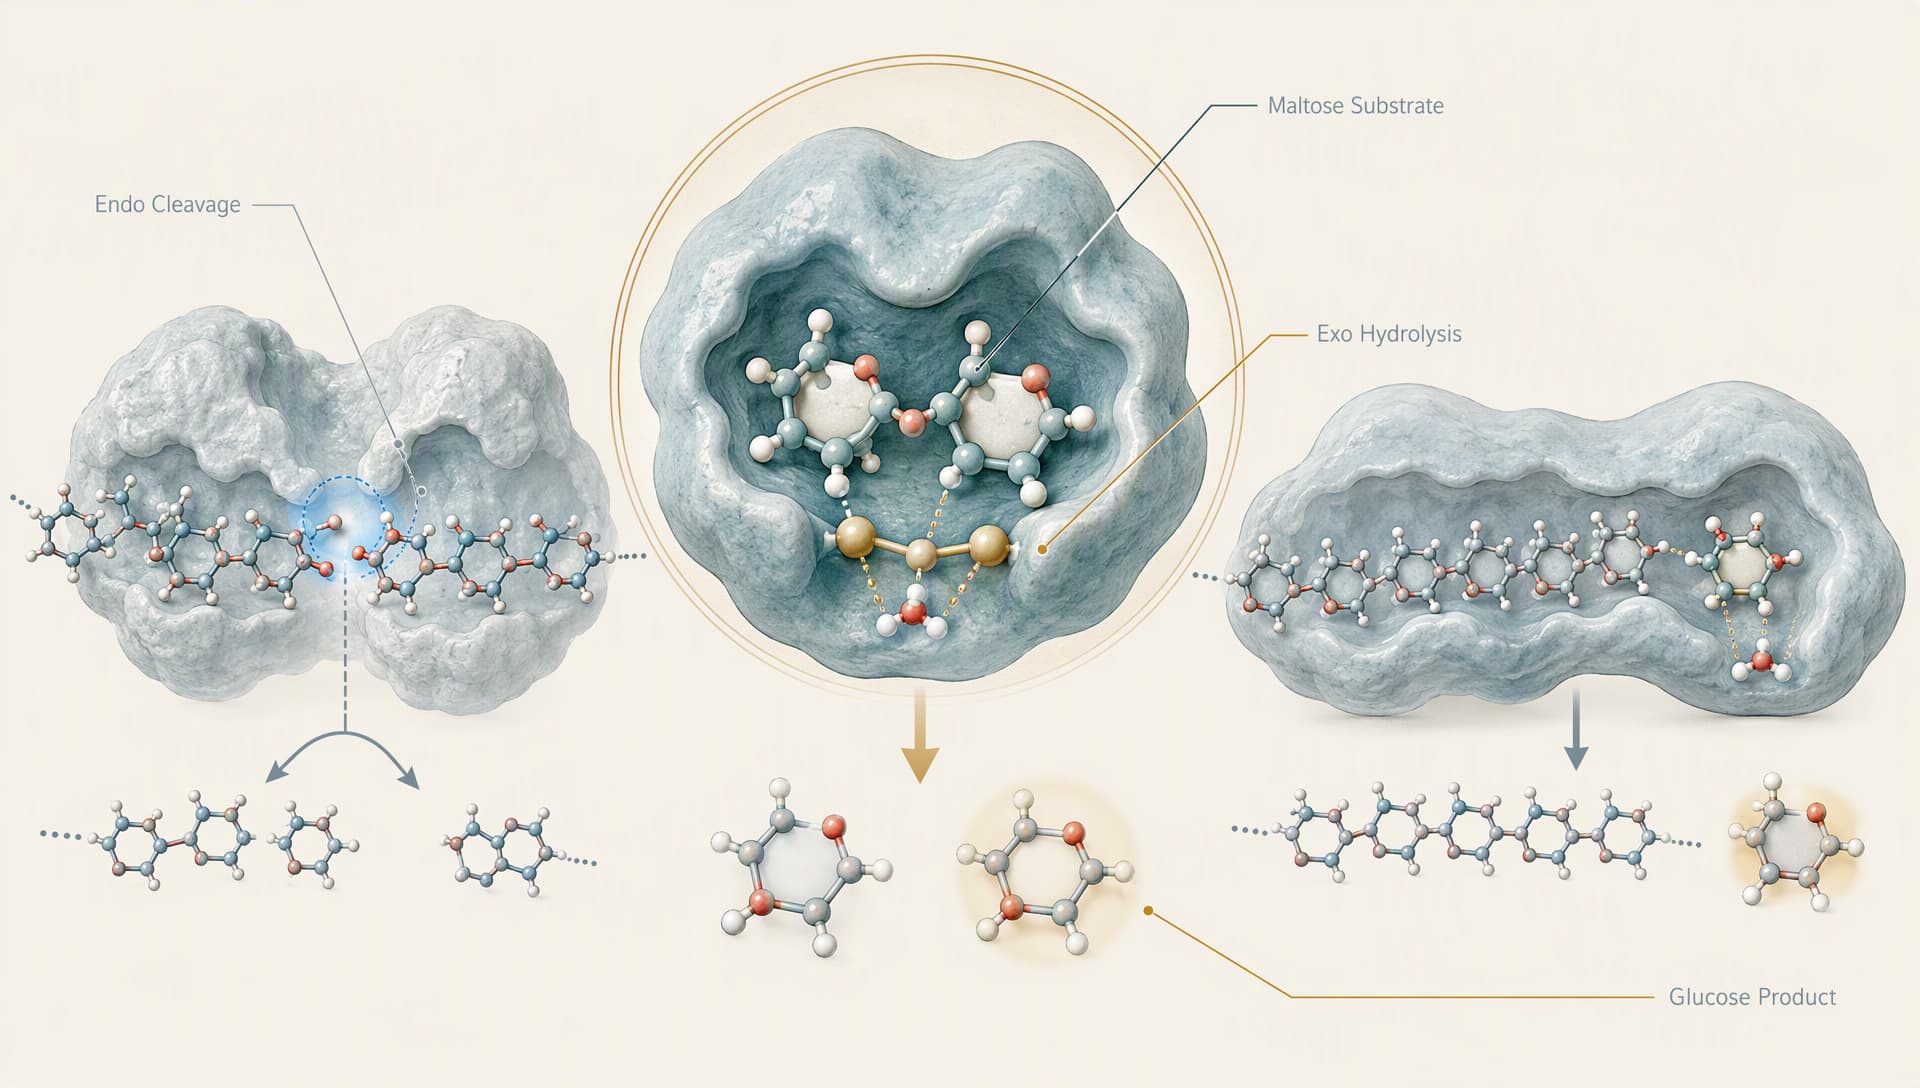
麦芽糖酶开发为何不能只看单一酶活
麦芽糖酶开发常因名称混用、模型底物依赖和稳定性评价脱离工艺而失准。文章从真实麦芽糖水解任务出发,拆解候选筛选、糖谱、动力学、工程化与放大验证,并说明计算筛选、湿实验和工艺放大如何形成可复核的开发闭环。
2026年10月21日
菠萝蛋白酶是什么?植物源性半胱氨酸蛋白酶的作用机制、最适条件与应用全解析
菠萝蛋白酶是一种从菠萝茎与果实中提取的天然植物源性蛋白酶,属于木瓜蛋白酶家族C1 类半胱氨酸内肽酶,通过攻击蛋白质肽键将其降解为多肽与氨基酸,因而在肉嫩化、食品澄清、啤酒冷稳定化及创伤清创等领域被广泛使用。
2026年10月21日
淀粉葡萄糖苷酶为何不能只看糖化率
淀粉葡萄糖苷酶(又名葡糖淀粉酶,GH15 糖苷水解酶,EC 3.2.1.3)选型不能只看终点糖化率。本文从底物支化、反应速率、热失活、副反应、批次一致性与放大转移六个维度,讲清为何“终点高”不等于“更适合生产”,并给出身份与样品状态、基准催化、真实糖化表现、工艺稳健性四层可解释评价框架,说明计算筛选、湿实验与工艺开发如何协同。
2026年10月21日
蛋白质序列空间智能搜索:从海量候选到可验证发现
蛋白质序列空间智能搜索把序列识别、证据检索、远缘发现、功能推断、属性筛选与实验验证连成一条可追踪的路径。本文用五步工作流与三态证据,说明如何筛出值得湿实验验证的候选。 一句话结论:搜索的价值不在命中更多序列,而在用更少实验覆盖更有信息量、更多样的候选。
2026年10月21日
定向进化阳性突变筛选:从海量变体到优选候选
定向进化阳性突变筛选的关键已不只是“做出更多变体”,而是结合功能位点保护、计算排序、组合建模与实验回流,缩小海量候选空间,把有限实验资源集中到更有价值的阳性突变体,并沉淀可用于下一轮设计的序列—功能证据。
2026年10月20日
酶序列挖掘,怎样找到值得验证的候选
酶序列挖掘不是在数据库中输入名称后下载一批相似序列,而是从目标反应、底物、应用条件与表达边界出发,逐层整合同源、基序、结构、系统发育和性质预测证据,最终形成可追溯、可排序、可实验验证的候选清单。
2026年10月20日
枯草杆菌蛋白酶研发如何贯通表达与测活
枯草杆菌蛋白酶通常用于描述subtilisin类胞外丝氨酸蛋白酶,但家族成员并不等同于同一条序列或同一种工艺酶。研发应从身份核对开始,把前体表达、自催化成熟、活性测定、底物图谱和发酵纯化连成闭环,避免用单一条带或终点读数代替完整判断。
2026年10月20日
迭代饱和突变实验设计如何少走弯路?
迭代饱和突变实验设计不只是“选几个位点做文库”,而是把证据检索、功能位点判断、文库规模、筛选质量和下一轮决策连成闭环。本文给出一套兼顾实验可执行性、数据利用率与结果可追溯性的设计思路。
2026年10月20日
蛋白质序列空间探索,如何找到有效路径
蛋白质序列空间探索不是把所有氨基酸组合逐一尝试,而是围绕目标功能、结构约束与实验反馈,判断哪些区域值得进入。有效策略应区分局部突变与远距离搜索,识别组合效应,并让每轮实验都缩小下一步决策范围。
2026年10月20日
高通量突变筛选,怎样让每个命中都可复现
高通量突变筛选的价值不只在于一次检测更多样本,而在于稳定地连接序列、表型和复核结果。文库覆盖、检测窗口、基因型追踪、筛选条件与确认实验必须共同设计,才能把海量信号转化为可靠候选。
2026年10月20日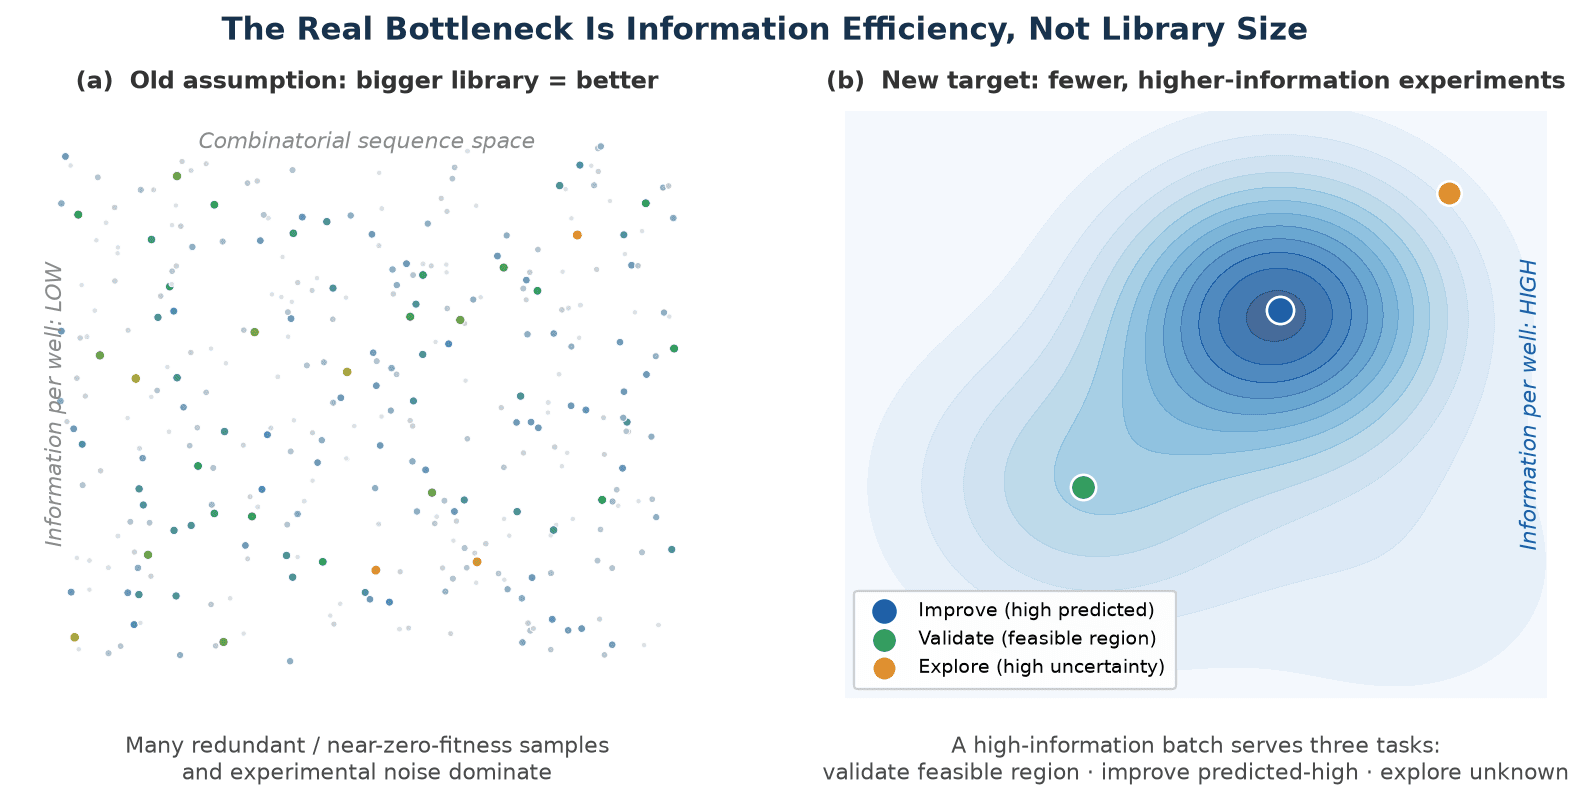
低通量条件如何做定向进化?让每次实验更值钱
低通量条件如何做定向进化?关键不是盲目缩小突变库或堆砌设备,而是把目标定义、先验证据、功能位点约束、首轮样本设计与主动学习串成闭环,让有限资源优先验证最有信息量的候选,并持续更新下一轮决策。
2026年10月20日
木瓜蛋白酶为何能高效切割蛋白质底物?
木瓜蛋白酶是经典半胱氨酸蛋白酶,依靠活性位点半胱氨酸完成肽键水解。它具有较宽的底物适应范围,但真实切割结果仍受底物构象、位点邻域、活性巯基状态、反应条件与终止时点影响。本文从催化机制出发,说明如何建立测活、选酶、表达及工艺控制路径。
2026年10月20日
酶稳定性,为什么先定义失活场景再谈改造
酶稳定性不是一个脱离条件的固定分数。温度、时间、pH、溶剂、浓度和操作方式都会改变失活路径。只有先明确真实工况与功能终点,再选择Tm、半衰期或残余活性等指标,稳定性改造才会指向可用结果,并守住活性边界。
2026年10月19日
迭代饱和突变,怎样让每轮实验都更有方向
迭代饱和突变不是把所有候选一次做完,而是让建库、筛选、模板更新和下一轮设计连续衔接。本文聚焦位点分组、文库边界、跨轮可比性、分支选择与停止条件,说明怎样把实验反馈转化为下一轮决策。
2026年10月19日
蛋白质定向进化实验流程:从目标到验证
系统拆解蛋白质定向进化实验流程,从目标定义、文库构建、筛选检测到数据回流与多轮验证,帮助科研与研发团队降低无效筛选、改善数据利用效率,并在真实应用条件下形成可复盘、可迭代的蛋白质工程闭环。
2026年10月19日
谷氨酰胺转移酶是什么?蛋白交联机制与实验流程
谷氨酰胺转移酶在本文中限定为转谷氨酰胺酶语境,重点讨论蛋白谷氨酰胺位点提供酰基、伯胺作为酰基受体的转移反应。研发成败不仅取决于酶活,还取决于名称核对、位点可接近性、反应窗口、交联质量和放大一致性。本文提供一条从序列确认到工艺验证的完整路径。
2026年10月19日
机器学习辅助定向进化:让蛋白优化更聪明
机器学习辅助定向进化把变体数据、序列—功能建模与湿实验迭代连接起来,帮助蛋白质工程团队从庞大突变空间中优先选择更值得验证的候选。本文用一条可执行的研发主线,说明如何定义目标、准备数据、规划实验并建立主动学习闭环。
2026年10月19日
机器学习定向进化,如何让实验数据决定下一批
机器学习定向进化的核心不是用算法替代实验,而是从已测变体中学习序列与功能关系,再把有限实验资源投向更有信息量的下一批候选。数据定义、模型验证、不确定性与反馈更新,共同决定这条路线能否真正落地。
2026年10月19日
谷胱甘肽硫基氧化酶是什么?从催化机制到蛋白折叠
谷胱甘肽硫基氧化酶参与蛋白巯基氧化和二硫键生成,其研发价值不仅取决于催化速度,还取决于底物构象、活性中心、表达质量与检测体系。本文围绕作用机制、底物边界、重组表达、酶活评价和工艺放大,梳理一条适合蛋白质工程团队执行的研发路径。
2026年10月19日
定点突变,如何把一个机制假设变成实验答案
定点突变的价值不在“改一个氨基酸”,而在用明确替换检验明确假设。本文围绕位点证据、侧链化学、计算筛选、实验对照与结果归因,说明怎样把候选突变组织成一条可验证、可复盘的蛋白质工程路径。
2026年10月19日
组合突变库设计方法:从位点选择到筛选闭环
系统解析组合突变库设计方法,从目标定义、位点分组、氨基酸集合、简并密码子到库容与筛选能力匹配,并说明如何协调计算预测与湿实验验证,帮助蛋白质工程团队构建规模可控、信息密度更高且便于迭代的突变库。
2026年10月19日
二硫键异构酶如何改善重组分泌蛋白的折叠质量?
二硫键异构酶是氧化蛋白折叠网络的重要成员,可参与二硫键形成、还原与重排。对于含多个半胱氨酸的分泌蛋白,表达量增加并不等于正确折叠增加。研发团队需要同时观察二硫键配对、活性、聚集、分泌负荷和细胞氧化还原状态,才能判断折叠辅助策略是否真正有效。
2026年10月19日
蛋白质大语言模型,读懂序列背后的生物规律
蛋白质大语言模型通过学习海量氨基酸序列中的上下文规律,把一条序列转化为可用于比较、预测与生成的数字表示。它不是会“读心”的蛋白质聊天机器人,也不能凭序列自动给出实验真相;真正价值来自任务适配、证据检索、结构约束和湿实验验证的共同作用。
2026年10月18日