
组合突变库设计方法:从位点选择到筛选闭环
发布于 2026年10月19日
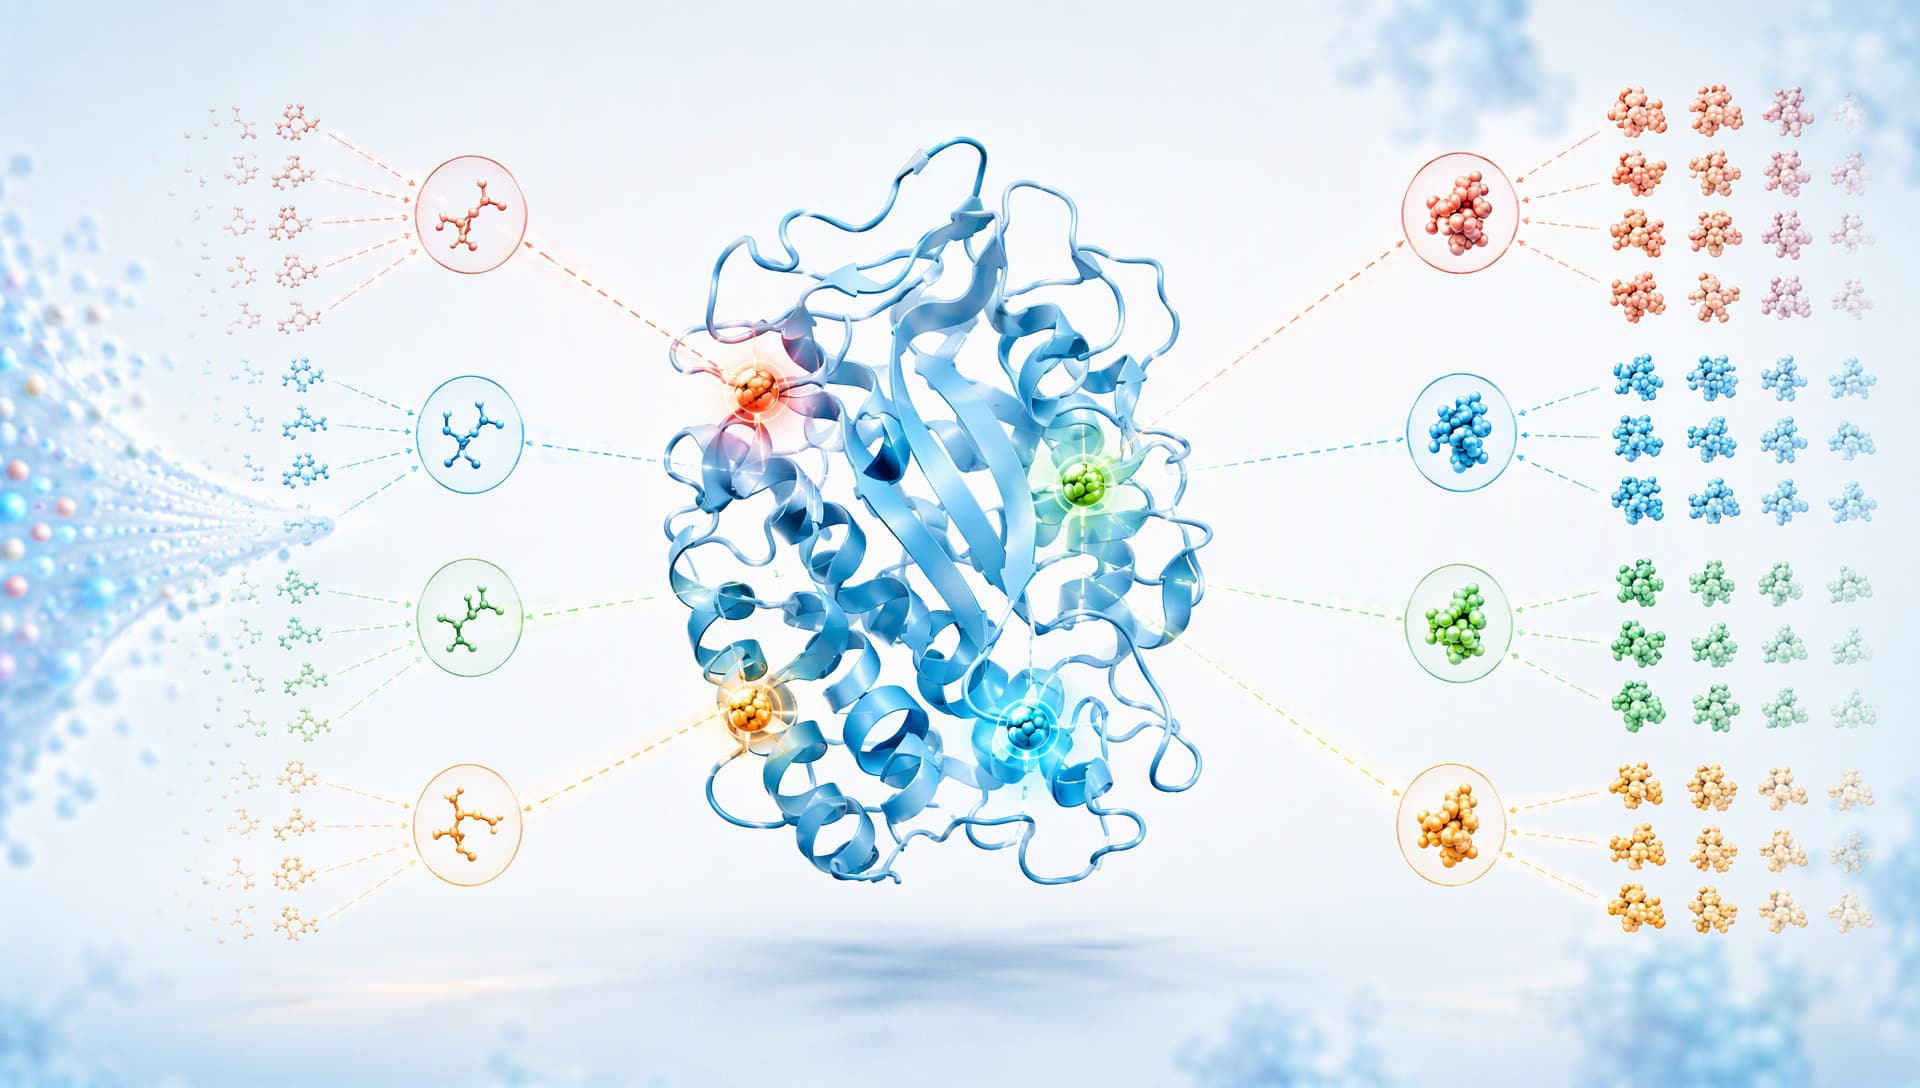
关键位点聚焦,让突变空间从庞杂走向可验证
分类: 蛋白质工程/ 定向进化 / 合成生物学
组合突变库的价值,不在于“做出更多序列”,而在于用有限的合成、转化和筛选资源,更高概率地覆盖有信息量的序列空间。真正有效的组合突变库设计方法,需要同时回答四个问题:为什么改、改哪些位点、每个位点允许哪些氨基酸,以及实验端究竟能筛多少个变体。只有把计算判断、建库约束与湿实验读出放进同一条决策链,文库规模才不会失控,命中结果也更容易解释和复现。
组合突变库设计方法先定筛选能力
很多项目习惯先列热点位点,再计算能得到多大的文库。更稳妥的顺序恰好相反:先确定可靠的筛选上限、检测动态范围和复筛成本,再反推可接受的理论库容。
若有4 个位点,每个位点保留 20 种氨基酸,理论组合就是 20⁴,即 160,000 种;增加到 6 个位点,则跃升至 64,000,000 种。实际建库还会受到密码子偏倚、克隆效率、转化效率和变体丰度不均的影响,因此“理论上存在”并不等于“实验中被充分覆盖”。
可以先建立一个简单的资源边界:
• 可筛选克隆数:不是仪器理论通量,而是能完成表达、检测和复筛的真实样本数;
• 最低覆盖目标:要不要覆盖全部组合,还是只需获得足够多的高价值候选;
• 阳性复核成本:初筛后的重复实验、测序和功能确认是否承受得住;
• 失败代价:漏掉弱阳性与接收假阳性,哪一种对项目影响更大。
这一步决定了组合突变库设计方法应走“全组合覆盖”,还是“小而精的分批迭代”。当筛选能力有限时,压缩氨基酸集合、拆分位点组或采用多轮迭代,通常比一次铺开全部组合更可控。
位点不是越多越好,而要有证据分层
位点选择应从“与目标性状的因果距离”出发,而不是只看结构上是否靠近活性中心。可将候选位点分为三层:直接参与催化或结合的位点、影响局部构象与通道的第二壳层位点,以及可能改变整体稳定性、表达或动态网络的远端位点。
一个实用做法是先保护不可轻易扰动的功能残基,再从以下证据中寻找可设计位点:
1. 已有数据库记录和文献中的实测变异;
2. 多序列比对显示的保守与可变模式;
3. 三维结构中的口袋、界面、通道和残基接触网络;
4. 单点扫描或已有湿实验中的增益与损失信号;
5. 不同证据共同指向、但尚未被充分验证的候选位点。
在MatwingsVenus®(晓鹜®)的蛋白质改造工作流中,可先检索先验证据,再用 VenusX 测绘功能位点、建立“禁触区”,随后用 VenusREM 评估单点突变效应。这类计算结果属于预测,适合帮助排序和缩小范围,不能替代实验测量。对建库团队而言,它的意义不是给出一个“唯一正确答案”,而是减少明显低价值的组合。
氨基酸集合决定文库的信息密度
确定位置后,下一步不是机械地让每个位点覆盖20 种氨基酸,而是为每个位点选择合理的替换字母表。完整饱和有利于发现意外解,但也会快速放大库容,并引入较多停止密码子、同义密码子和低概率有效变体。

合理压缩氨基酸集合,可提升文库的信息密度
设计氨基酸集合时,可综合考虑:
• 化学性质覆盖:保留疏水、极性、带电和芳香族等代表性侧链;
• 结构环境:核心位点避免过多破坏性替换,表面位点可保留更宽的电荷与极性变化;
• 进化信息:优先纳入天然同源序列中出现过、且与目标功能相容的残基;
• 目标性状:活性、选择性、稳定性和表达量所需的侧链变化并不相同;
• 合成方案:比较NNK、NDT 等简并方案与定制混合密码子的实际覆盖、冗余和成本。
因此,高质量组合突变库不是“随机性最大”,而是“每一个被纳入的变体都更值得测”。若多个位点存在潜在上位性,可保留必要的化学多样性;若某个位点证据较弱,则应缩小集合,或先放入单点验证轮次。
组合突变库设计方法如何分组位点
组合突变的核心价值,是观察单点效应相加之外的协同或拮抗。然而,把所有候选位点放进一个库,往往会让有效信号淹没在指数增长的背景中。
更具可执行性的组合突变库设计方法,是按空间关系、功能模块和筛选能力进行分组。例如,把底物入口附近的2—4 个残基作为一组,把影响整体稳定性的远端位点放入另一组;先分别筛选,再将已验证的有益位点重组。对于存在明确迭代路径的任务,也可以采用“筛一轮、保留多个优选模板、再扩展下一组位点”的策略,避免过早陷入局部最优。
这里有三个关键判断:
• 相邻位点不一定协同,远端位点也不一定无关,分组要结合结构与数据;
• 每轮不要只保留单一冠军,可保留功能不同或置信区间相近的候选;
• 上一轮的阳性结果应反馈到下一轮位点与氨基酸集合,而不是原样追加突变。
当项目已有一定量的序列—性能数据时,MatwingsVenus®(晓鹜®)中的 VenusPrime 可用于多点组合建模;若任务进入多轮定向进化,且具备必需的实验数据文件,则可通过 ALDE 辅助主动学习式选点。二者都应作为候选排序与实验决策支持,并持续接受湿实验反馈校正。
把筛选读出设计成建库的一部分
“你筛什么,就更可能得到什么。”如果检测指标与最终目标不一致,再漂亮的文库也可能把项目带向错误方向。活性提升、底物选择性、热稳定性、表达量和抗聚集性,可能需要完全不同的初筛条件与复筛门槛。
建议在合成文库之前,就冻结以下实验定义:阴阳性对照、检测窗口、重复数、批间归一化方式、阳性阈值、复筛标准与测序回溯方案。若采用替代底物或间接报告信号,还应验证它与目标性质之间的相关性。初筛追求通量,复筛强调定量与可重复,两者不应混为同一层判断。

计算与实验持续回流,才能形成可靠设计闭环
MatwingsVenus®(晓鹜®)强调“检索优先”和预测结果分级:先查权威数据库与既有证据,再进入功能位点、单点扫描或多点组合建模;输出中的预测结论仍需湿实验验证。将这种边界意识带入组合突变库设计,可以让团队清楚区分“已实测”“计算预测”和“仍未知”,减少把模型分数直接当作性能结论的风险。
一套可落地的设计检查清单
在提交寡核苷酸或基因合成订单前,可以用以下问题快速复核:
• 优化目标是否能被当前检测体系直接、稳定地读出?
• 候选位点是否有序列、结构、文献或实验数据支持?
• 是否明确了不可扰动的功能位点与结构风险区?
• 每个位点的氨基酸集合是否服务于目标,而非默认全饱和?
• 理论库容、预期覆盖度和真实筛选通量是否匹配?
• 简并密码子是否带来不可接受的冗余或停止密码子?
• 是否设计了多模板保留、复筛和下一轮迭代规则?
• 所有预测是否都对应明确的实验验证路径?
总结:好的文库是在约束中提高命中率
组合突变库设计方法的本质,是在序列多样性、证据质量与实验资源之间做工程化取舍。先用目标和筛选能力划定边界,再以序列、结构、功能位点和单点数据筛选候选位置;随后压缩氨基酸集合、合理分组,并让每轮实验结果回流到下一轮设计。这样的文库可能没有最大规模,却更容易获得可解释、可复验、可继续优化的候选,为蛋白质改造建立真正可持续的迭代路径。
