
低通量条件如何做定向进化?让每次实验更值钱
发布于 2026年10月20日
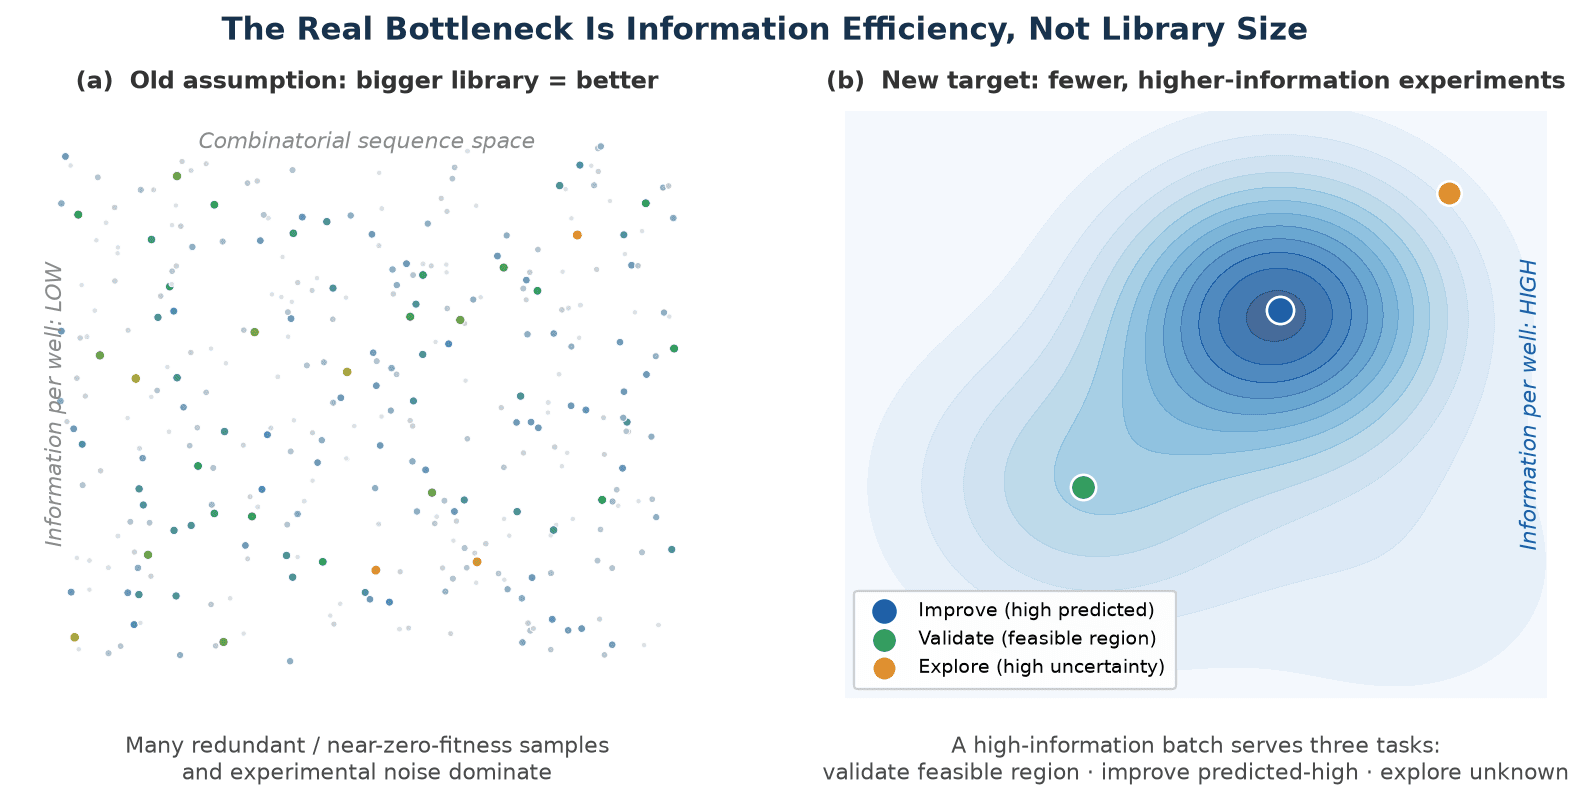
Fig. 1. Information efficiency, not library size or equipment count, is the real bottleneck under low-throughput screening.
分类:领域|蛋白质工程;方法|定向进化;应用|AI for Science
一、真正的瓶颈是信息效率,而非库大小或设备数量
有限实验也能沿高信息路径逼近更优蛋白,前提是改变评价标准——不是比较“本轮测了多少”,而是判断“本轮是否减少了下一轮的不确定性”。传统定向进化常把“库越大越好”当作默认前提,但蛋白质序列空间随突变组合近似指数扩张,多位点组合还会出现非加和的上位性效应;继续随机扩库,常见结果是重复测到相似序列、低活性样本占满名额、实验噪声掩盖真实差异。
一个高信息量批次至少要同时承担三项任务:
验证可行区——确认哪些序列邻域仍保持折叠、表达或基础功能;
寻找提升区——优先测试预测值较高且机制上可解释的候选;
探索未知区——保留少量差异较大或模型不确定的样本,避免过早收敛。
二、如何做:先收缩、明确搜索空间(证据—位点—约束三步法)
低通量不是把大库随机砍小,而是有依据地减少无效组合。更稳妥的起点可以概括为“证据—位点—约束”三步。
1.先建立可追溯的野生型基线
先检索已知序列、结构、功能注释、动力学数据和公开突变信息,再补充团队已有的表达量、活性、稳定性或亲和力数据。每条结论都应区分实测、预测与未知,避免把计算分数直接当作实验事实。对话式蛋白质研发智能体可以协助汇集数据库线索、梳理证据状态并生成待验证清单,但检索不到的数据仍应保留为未知。
2.把关键功能残基设为“禁触区”
结合已知注释、结构邻域、进化保守性与功能位点预测,先标出催化残基、结合热点、构象开关及潜在结构核心。除非研究目标就是重塑这些区域,否则应优先保护它们。智能工作流可把位点检索、功能位点测绘和单点突变效应评估串联起来,为候选位点提供可解释的排序依据。
3.控制组合复杂度
与其同时开放十几个位点,不如先选择少量、机制互补且空间分散的位点。若采用数据驱动主动学习,还要确认实验数据格式统一、测量方向一致,并保留野生型和必要对照。某些主动学习工作流会对位点数和输入数据提出明确要求,启动前应按实际工具契约核对。

Fig. 2. Evidence–Site–Constraint (a three-step method) shrinks and clarifies the search space before sampling.
三、模型与实验闭环协作,持续提高样本信息量
对话式智能体的价值,不是承诺一次命中最优解,而是把检索、位点约束、候选排序、实验数据回填和下一轮推荐组织成可追踪流程;涉及突变设计、建模等重计算时,仍应由研究者确认输入、目标与预期输出后再执行。从位点约束到实验回填,决策链清晰可追踪。
以下几点最容易浪费有限通量,应尽量避免:
只选模型最高分——容易陷入局部最优,也无法改善模型对未知区域的判断;
把历史数据直接拼接——不同批次的底物浓度、温度、检测窗口若不一致,标签可能不可比;
只记录成功变体——失败结果能帮助模型识别无效区域,应连同条件一起保留;
一次放开过多位点——组合空间骤增,有限实验很快失去覆盖意义;
把预测值写成实测值——单点扫描、组合建模和结构评分都应标记为预测,并由湿实验确认。
四、可执行流程:五步闭环
第一步:把“更好”写成可测指标。明确主目标、约束项和淘汰线。例如主目标是催化活性,约束可能包括表达量、稳定性和底物选择性。不要在中途频繁更换标签定义,否则不同轮次难以合并训练。
第二步:设计小而有差异的首轮样本。首轮不是只挑预测最高的变体,应混合已有优良变体、局部单点变体、机制上合理的组合以及少量高不确定候选。已有研究提示,训练集设计本身会显著影响机器学习辅助定向进化,过多近零适应度的低信息样本可能浪费有限名额。
第三步:统一实验与质控。使用固定批次对照、技术重复和一致的数据归一化方法。低通量项目的数据点少,一个异常值的影响会被放大;必要时宁可减少候选数,也要保留对照与重复。
第四步:让模型同时看“潜力”和“不确定性”。多点组合建模可对候选排序,主动学习则进一步决定下一批应该验证什么。建议把名额分为三部分:利用高预测候选、探索高不确定候选、验证序列多样性候选。比例不必固定,应随轮次和模型校准情况调整。
第五步:小批量迭代并设置停止规则。每轮回填真实实验值,记录失败样本和实验条件,再重新训练或更新模型。当连续数轮提升趋缓、候选差异收敛,或验证成本超过预期收益时,应停止扩展,转入机制验证与复现。
这套流程解释了低通量条件如何做定向进化:计算负责缩小选择范围,实验负责提供真实标签,两者通过多轮反馈共同修正方向,而不是让预测替代实验。

Fig. 3. A five-step closed loop couples model and experiment so that each round raises the information per sample.
常见问题
起始数据很少,还能启动吗?
可以,但应降低模型复杂度,优先保证标签一致,并通过先验证据和结构约束提升首轮样本质量。首轮的目标是建立可学习信号,而不是立刻找到全局最优。
每轮应该测试多少个变体?
没有适用于所有项目的固定数字,应由可用孔位、对照与重复需求、测量噪声和候选多样性共同决定。核心是每轮都同时保留利用、探索与质控名额。
没有蛋白结构怎么办?
可先利用序列注释、保守性、同源信息与已有功能数据缩小范围;需要结构相关判断时再使用预测结构,并明确其预测属性。不要因缺少实验结构就跳过功能位点保护。
低通量条件如何做定向进化才能避免过拟合?
保持独立验证样本,控制特征和模型复杂度,关注预测不确定性,并检查不同轮次的实验一致性。最终候选应复测,并在必要时进行机制或结构验证。
小结:把有限实验变成连续学习资产
低通量条件如何做定向进化,本质上是一个实验设计问题:先用证据和功能约束缩小空间,再用高信息量首轮样本启动模型,通过主动学习选择下一批,并让每一轮真实测量回流到决策系统。若希望减少工具切换和信息断层,可采用具备数据库检索、功能位点分析、突变评估、多点组合建模与实验数据迭代能力的对话式蛋白质研发智能体,先明确目标和数据条件,再生成一份可审核、可执行的小批量进化计划。
