
蛋白质界面设计是什么?从分子界面识别到AI 驱动的工程改造
发布于 2026年10月28日
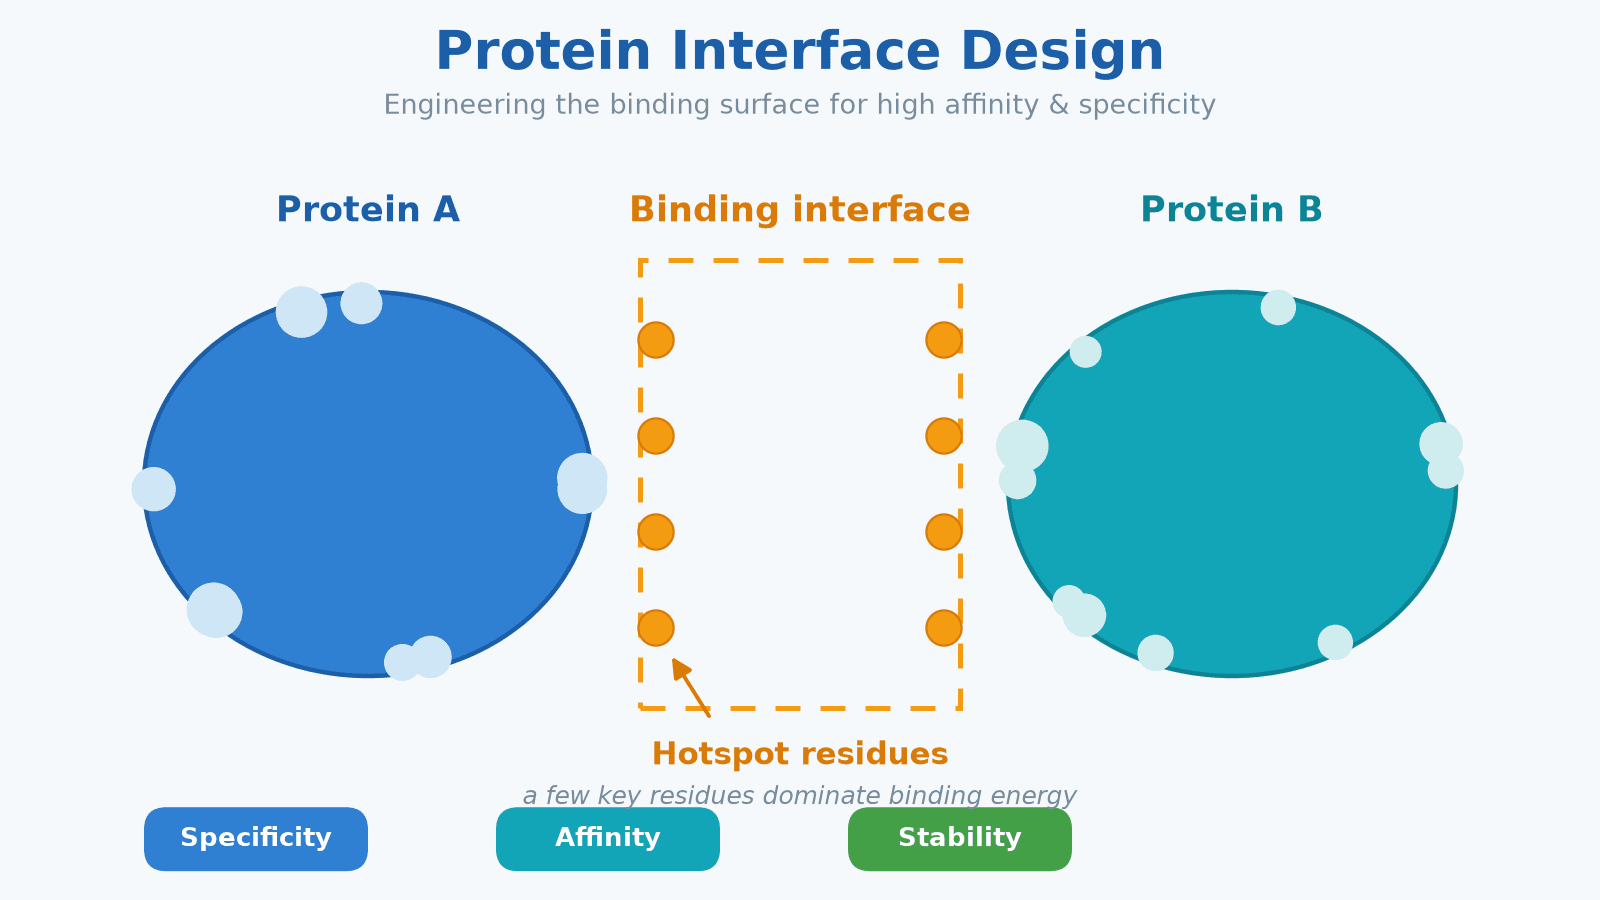
图1 蛋白质界面:蛋白互补结合并标记热点残基
分类:C(定向进化/蛋白工程),跨 E(结构/机制/序列分析)
引言
蛋白质界面设计(Protein Interface Design),指的是在蛋白质与其结合伙伴(另一蛋白质、肽、抗原表位或小分子配体)直接接触的结合面上,进行有目标、可计算、可验证的改造与优化。它的目标很朴素:让结合更"准"、更"牢"、更"稳"。
如果把蛋白质比作"分子机器",那么界面就是它与其他分子"握手"的地方。一个抗体要识别肿瘤抗原、一个酶要抓住底物、一条信号通路要传递信息,靠的都是界面上的精准接触。正因如此,界面是蛋白质工程中最值得也最容易被"设计"的靶点——改动界面上的个别氨基酸,往往就能显著改变结合行为,而不必重造整条蛋白链。
为什么蛋白质界面如此关键?——背景与机制
蛋白质界面(protein interface)是指一个蛋白质与它的结合伙伴直接接触、相互作用并交换结合能的表面区域;界面上少数被称为"热点残基"(hotspot residues)的氨基酸,往往贡献了大部分结合自由能,因此成为蛋白质设计与改造的焦点。
• 并非所有界面残基都同等重要:经典的丙氨酸扫描(alanine scanning)实验表明,把界面残基逐一替换为丙氨酸后,往往只有少数几个残基的突变会让结合能显著下降,这些残基就是热点残基。
• 热点残基决定结合强度:热点残基通常位于界面中心、被周围残基良好"包裹",通过疏水堆积、氢键和盐桥贡献能量;它们就像一座桥的主承重柱。
• 界面决定功能边界:界面不仅决定能否结合,还决定结合的特异性(只认目标伙伴)、亲和力(结合多牢)与稳定性(在何种条件下仍能维持)。
• 改造收益高、代价可控:由于热点较少,界面设计通常只需改动少数几个位点,就能带来可观的亲和力提升,相比大规模扫描更省时省力。
• 场景覆盖广:抗体-抗原表位、酶-底物、受体-配体,以及复杂的蛋白-蛋白互作网络,都离不开对界面的精细调控。
理解界面为什么关键,是设计的起点;而真正要动手改造,则需要看清界面上到底有哪些"接触元件"。
蛋白质界面的结构原理与分子识别
蛋白质界面的结合由多种非共价接触共同驱动,主要包括氢键、疏水堆积、盐桥与范德华力;这些接触在界面上形成互补的形状与化学性质,共同决定结合的亲和力、特异性与可逆性。
• 形状互补:两个蛋白的界面在几何上高度吻合,如同"锁与钥匙",但通常伴随结合后的构象微调(诱导契合),让两个表面逐步"咬合"得更紧。
• 化学互补:界面上疏水对疏水、带电对带电、极性对极性,形成互补的静电与疏水分布;电荷不匹配或极性错位,往往直接削弱结合。
• 接触类型:氢键提供方向性与特异性,像精确对准的插销;疏水堆积贡献主要的结合能,如同将油滴挤出水分而紧紧贴合;盐桥提供长程静电吸引;范德华力则在紧密接触中累积成可观的总和。
• "包装度"(packing)与界面面积:成熟界面的面积通常在数百至上千平方埃,且内部残基排布紧密、水分子被排出——越是"干"、越紧密的界面,往往越稳定。
• 构象代价:结合前后发生的构象变化,是需要支付的"变形能";如果变形过大会抵消接触带来的收益,这正是部分界面设计困难的根源。

图2 界面分子基础:氢键、疏水堆积与盐桥
如何测定与验证蛋白质界面?
验证蛋白质界面设计通常需要三类证据:结构层面的晶体或冷冻电镜结构、结合层面的亲和力/动力学测定,以及功能或稳定性层面的活性与热稳定性检测;三者结合,才能确认界面是否被真正设计成功。
• 结构证据:X 射线晶体学、冷冻电镜或 NMR 可直接观察界面构象;无实验结构时,可用高置信度预测模型辅助判断,但需理解其局限。
• 结合证据:表面等离子共振(SPR)、生物膜干涉(BLI)、等温滴定量热(ITC)、ELISA 等测定结合亲和力与动力学常数。不同方法各有侧重:SPR/BLI 关注快慢与强弱,ITC 直接给出热力学参数。
• 功能与稳定性证据:酶活或报告基因活性、热变性温度(Tm)、表达量与聚集倾向,反映界面改造是否带来"可用"的开发现性。
• 突变验证:丙氨酸扫描、深度突变扫描(deep mutational scanning)可系统定位关键残基,同时为机器学习提供高质量数据。
• 数据即燃料:对AI 驱动的界面设计而言,测定的质量直接决定模型的预测上限;因此"测什么、怎么测、如何标准化"往往是项目成败的关键一环。
蛋白质界面设计的工程化流程与关键条件
一个可复用的界面设计闭环通常包括:输入序列或结构→界面与热点分析→计算/机器学习生成候选突变→湿实验表达与验证→测定数据回灌模型→主动学习更新模型,如此循环,直至达到目标亲和力与稳定性。
• 输入:复合物序列或结构,是设计的起点;结构越可靠,后续分析越有依据。
• 界面与热点分析:识别界面残基、热点残基与可改造位点,划定设计空间,避免盲目扫描。
• 生成候选:用能量函数、物理模型或机器学习模型预测突变效应,输出排序后的候选集合,供实验筛选。
• 湿实验验证:表达、纯化、测定,获得真实亲和力与稳定性数据;这一步把"纸面设计"变成"可确认的事实"。
• 数据回灌与主动学习:把真实数据用于再训练模型,主动挑选信息量最大的下一轮候选,让每一轮实验更"值"。
用一次典型的抗体界面优化举例:拿到抗体-抗原复合物结构后,先定位 CDR 与表位接触残基,识别其中的热点;然后用模型生成几十到几百个候选突变并按预测效应排序;进入湿实验后,表达纯化并测定亲和力,把"哪些突变真能提升、哪些反而有害"的真实数据回灌模型;最后一轮再用更新后的模型主动挑选最有价值的组合,从而用更少的实验换来更大的提升。这个过程每循环一次,对界面的理解就更深一层。
关键条件与参数
• 界面残基选择:优先改造热点与界面暴露残基,避免破坏核心折叠或催化残基。
• 设计空间:单点扫描适合快速定位,多点组合可增强效应,但需控制组合爆炸与协同效应。
• 评估指标:ΔΔG(结合能变化)、亲和力、热稳定性、可开发性需同时权衡,单一指标容易"顾此失彼"。
• 迭代轮次:计算-实验闭环通常需要多轮收敛;数据质量越高、设计空间越合理,收敛越快。

图3 AI驱动界面设计闭环:设计—验证—学习—迭代
MatwingsVenus®(晓鹜®)如何赋能蛋白质界面设计
MatwingsVenus®(晓鹜®)把结构解析、机器学习与湿实验验证整合为干湿闭环平台,帮助研发团队把蛋白质界面设计从依赖经验的试错,转变为由数据驱动、可追溯、可迭代的工程流程。
• 干湿闭环平台:把计算设计与真实测定打通,界面设计的每一轮假设都能被实验检验并回灌模型,从而持续逼近目标。
• 专家支持:对于缺少结构或数据的项目,可从界面识别、突变方案到实验验证获得系统性支持,降低使用门槛。
• 按阶段选型:立项阶段关注可行性,设计阶段需要高效候选生成,验证阶段需要稳定可靠的测定;可结合湿实验平台、专家中心与干湿闭环平台按需组合。
对研发团队来说,MatwingsVenus®(晓鹜®)的价值不在于"替代"你的实验,而在于让每一次界面设计都建立在清晰的结构与数据之上:先理解界面、再生成候选、最后用真实测定验证并回馈,形成真正可复用的工程闭环,而非一次性碰运气。
FAQ
蛋白质界面设计主要应用在哪些场景?
蛋白质界面设计广泛应用于抗体与抗原表位的亲和力优化、酶与底物的结合改造、蛋白-蛋白互作网络的调控,以及双抗、CAR-T 等复杂分子的界面工程。
界面设计与亲和力成熟有什么区别?
界面设计着眼于对整个结合界面的理解与重塑,往往从结构、能量和机理出发做系统改造;亲和力成熟则更专注于在已有抗体基础上提升结合强度,两者在项目中常结合使用。
计算设计的结果一定可靠吗?还需要湿实验吗?
计算与机器学习设计能大幅缩小候选空间并给出可解释的方向,但真实亲和力与稳定性仍受表达、折叠、聚集等实际因素影响,因此湿实验验证与真实数据回灌不可或缺。
做蛋白质界面设计需要哪些数据或结构?
通常需要复合物结构(实验结构或高置信度预测)或已系统测定的界面亲和力数据;结构越接近真实构象、测定数据越系统,界面设计的成功率越高。
总结
蛋白质界面设计把"高亲和力、高特异性"从经验摸索变成可计算、可验证、可迭代的工程:理解界面机理、精准识别热点残基、用测定数据驱动机器学习,并在干湿闭环中持续逼近目标。无论研究对象是抗体、酶还是蛋白-蛋白互作,掌握界面的分子逻辑,就是掌握了工程改造的"第一性原理"。
