
未培养微生物酶发现:如何解锁地下99%的酶库?
发布于 2026年10月26日
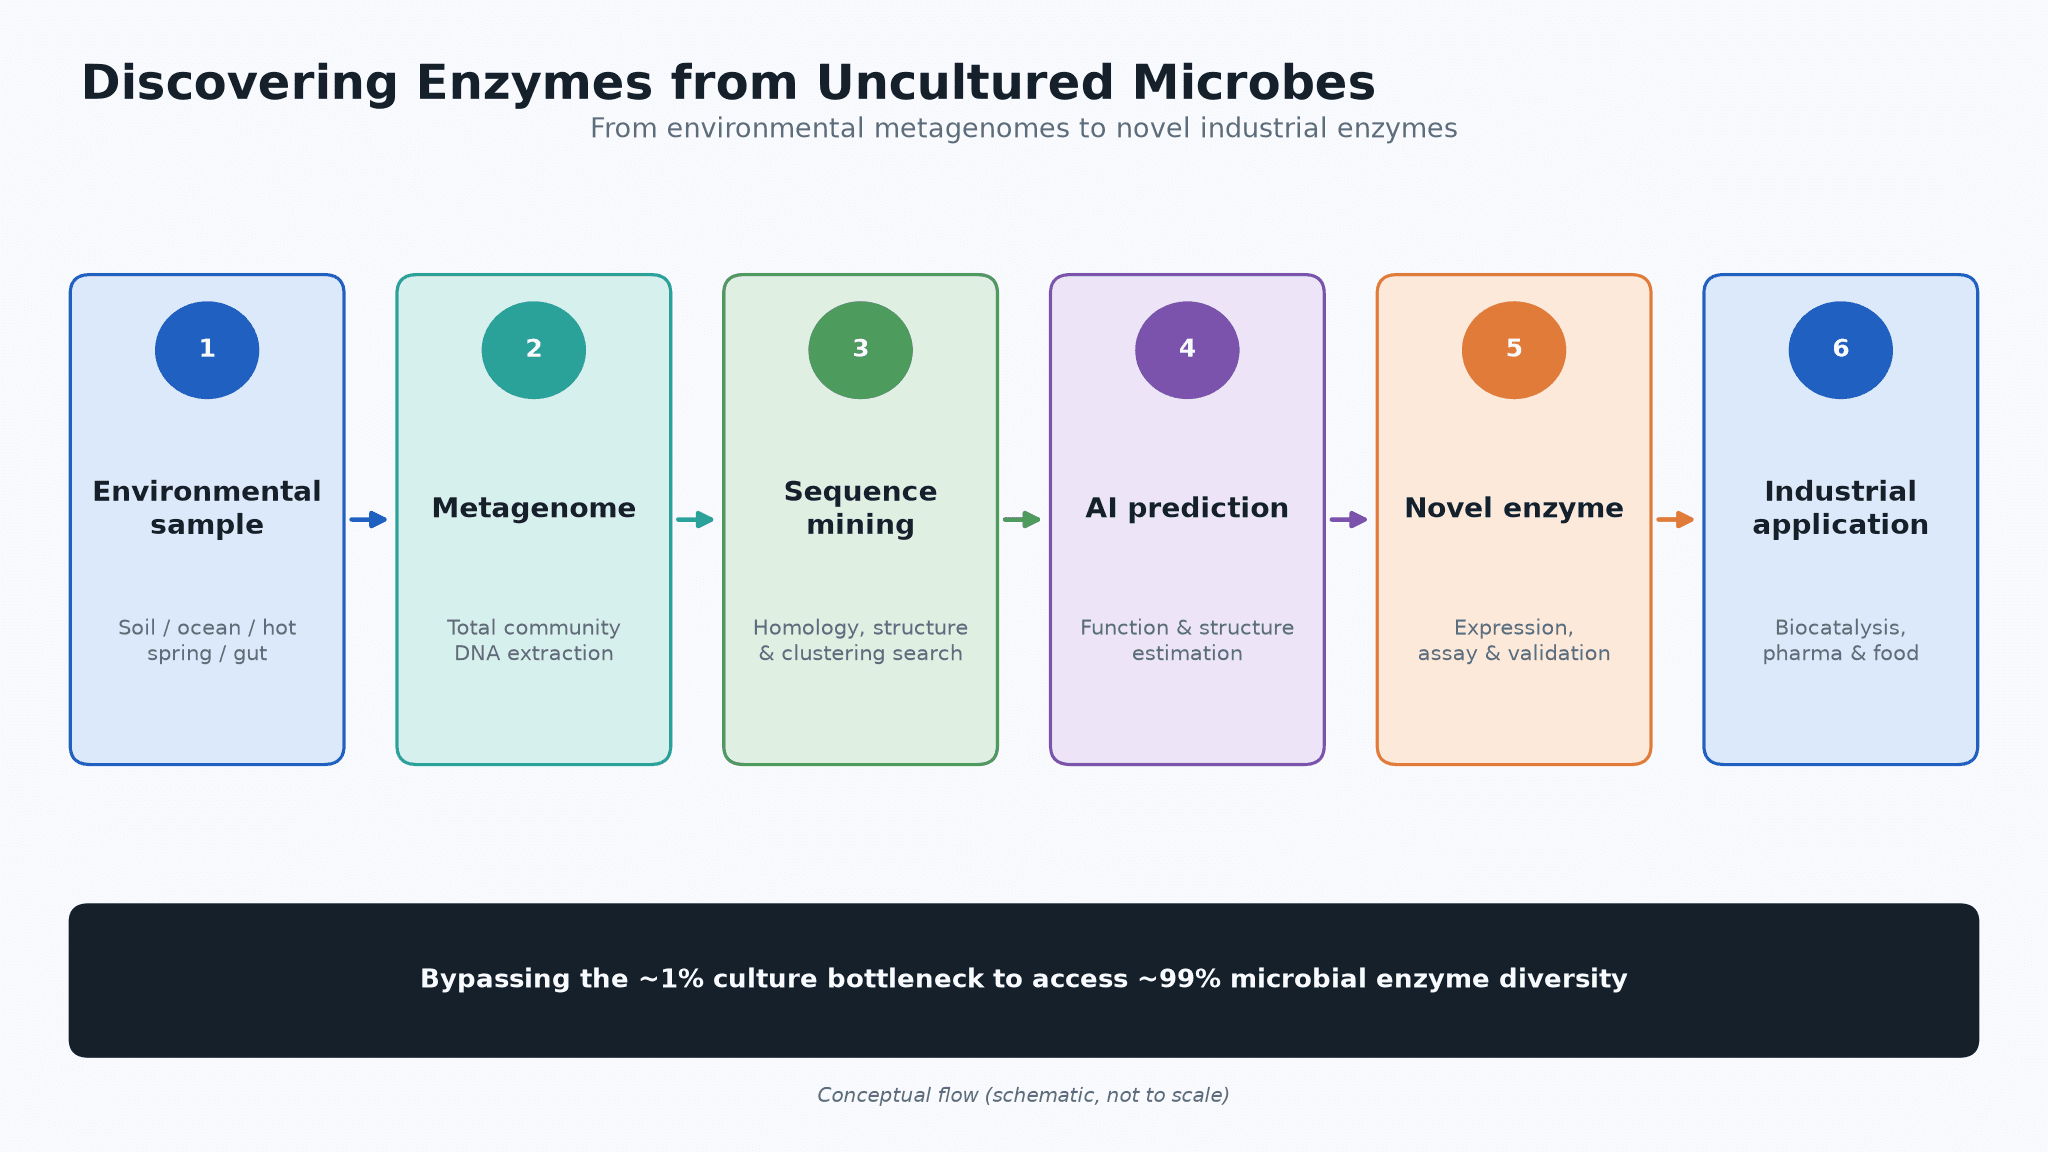
自然界里,能被我们在实验室中“请”出来培养的微生物只占极少数。据学界长期共识,超过 99% 的微生物至今无法用常规方法培养——这意味着,它们所蕴含的酶,长期处在我们的视野之外。未培养微生物酶发现,正是要打开这扇被忽视的大门:不依赖培养,直接读取环境中的“总 DNA”,再借助 AI 从浩如烟海的序列里找出可用的酶。这篇文章带你从环境样本、到序列、再到工业产品,看清这条新路径。
一、背景/机制:为什么 99% 的微生物酶一直“看不见”?
传统酶发现依赖“先培养、再筛选”:把微生物在培养皿里养出来,再测它的酶活。可现实是,绝大多数微生物对培养条件极其挑剔,在实验室环境下根本长不出来。于是,一个巨大的“暗物质”酶库被搁置了。
宏基因组学(metagenomics)绕开了培养这一环:它把环境样本(土壤、海洋、热泉、肠道、堆肥等)中所有微生物的 DNA 一次性抽出、切碎、测序,得到的是整个微生物群落的“总基因组”。虽然我们仍养不出这些微生物,但已经能“读”到它们的基因——其中就包含海量从未被研究过的酶。
这正是未培养微生物酶发现的核心逻辑:把“能培养的酶库”扩展为“可读取的酶库”。
二、原理/结构:宏基因组 + AI,如何从环境 DNA 里“淘”出酶?
从成堆的序列里找到真正有用的酶,主流有两条路线。

关键机制:宏基因组挖酶的两条路线与AI增强
• 序列挖掘(sequence-based):以已知酶的序列或结构为“种子”,在宏基因组中检索同源基因。适合寻找“已知家族的新成员”,例如新的耐热酯酶、蛋白酶、糖苷酶。
• 功能筛选(function-based):把宏基因组DNA片段转入表达宿主(如大肠杆菌),直接测定活性。适合寻找“前所未见的催化功能”——哪怕序列陌生,只要能干活就行。
两条路线各有取舍:序列挖掘快、通量大,但容易“挖”到已知家族;功能筛选能发现全新功能,却更耗时、筛选压力更大。
AI 正在把两者同时提速:蛋白质语言模型可以从序列直接预测结构与功能,帮助在数十亿条候选中快速排序、去重、挑出最可能“可用”的酶;结构预测工具则把“序列相似性”扩展到“结构相似性”,让那些序列相似度低、但功能相似的酶也能被捞出来。AI 挖酶不是替代湿实验,而是把有限的实验资源,提前集中到最值得验证的候选上。
三、测定/选型:拿到候选序列,如何判定它是“好酶”?
序列命中只是起点。判断一个候选酶值不值得投入,通常要过几道“关卡”:
• 活性:能否催化目标反应,活性有多高(例如比活、转换数kcat)。
• 特异性/选择性:是否“指哪打哪”,副反应多不多。
• 稳定性:耐温、耐pH、耐溶剂、耐氧化,能否扛住工业条件。
• 动力学/表达性:底物亲和力(Km)、表达量与可溶性,是否适合规模化。
选型时,凡未经实验验证的活性、动力学与稳定性数值,都属于“预测”而非“实测”,应以实验实测为准。这也是为什么“找到序列”和“拿到可用酶”之间,还隔着一条完整的验证链。
四、条件/工艺:从序列到工业酶,需要哪些工艺条件与控制?
把候选序列变成能上产线的酶,是一条“干湿闭环”的工艺链路。

应用/工艺流程:从未培养微生物酶序列到工业酶的干湿闭环
1. 干实验(AI设计):对候选基因做注释、打分、排序,确定最有希望的“种子”。
2. 基因合成与表达:合成序列,转入合适的表达宿主(细菌、酵母、真菌等),小量表达。
3. 湿实验验证:测定活性、稳定性、动力学,确认它是不是“好酶”。
4. 放大发酵与下游工艺:优化培养基、pH、温度、诱导条件,把产量与纯度做上去,再做纯化、固定化等。
5. 数据回流:把湿实验数据反馈给模型,用于下一轮设计——形成“设计即验证、验证即迭代”的闭环。
工艺控制的关键,在于表达宿主选择、诱导条件、pH/温度窗口,以及目标酶在复杂体系中的稳定性。不同酶的最适条件差异巨大,因此“经验 + 数据”的迭代十分重要。
五、MatwingsVenus®(晓鹜®)如何赋能未培养微生物酶发现?
MatwingsVenus®(晓鹜®)是面向高校科研工作者、企业研发人员与生物爱好者打造的“AI 生物设计 + 湿实验验证 + 专家协同”研发闭环平台。针对未培养微生物酶发现,它主要在以下几处发力:
• AI挖酶:从大规模、多源整合的蛋白质序列与功能标注数据中,挖掘耐高温、耐高压、耐酸/碱等极端耐受天然蛋白,把“序列命中”的召回率做大。
• 序列-结构-功能理解:蛋白质语言模型从序列直接预测结构与功能,为“相似度低但功能相近”的候选打开入口。
• 对话式干湿闭环:以自然语言输入任务目标,智能体自动拆解并调度设计、预测、分析能力,再把结果衔接到自动化湿实验,实现“设计即验证、验证即迭代”。
• 专家协同:在关键节点可发起专家咨询,对AI设计结果做专业评估与优化建议。
六、常见问题(FAQ)
1. 什么是“未培养微生物”?为什么难以在实验室培养?
绝大多数环境微生物无法用常规培养基在实验室条件下生长,原因包括营养需求未知、难以模拟其天然生态、生长缓慢或依赖共生等。因此它们被称为“未培养微生物”,其基因资源长期无法通过传统培养法获取。
2. 未培养微生物酶发现和传统培养法有什么不同?
传统培养法是“先培养、再筛选”,只能触达可培养的那一小部分;未培养微生物酶发现(宏基因组路径)直接读取环境 DNA,先找基因、再验证功能,从而覆盖更广的酶库。
3. 序列挖掘和功能筛选,应该选哪条路线?
如果目的是“已知家族的新成员”或追求通量与速度,序列挖掘更合适;如果目的是“全新未知功能”,功能筛选更直接。现实项目中常两者结合,再用 AI 提升筛选效率。
4. AI 在未培养微生物酶发现中扮演什么角色?
AI(蛋白质语言模型、结构预测、聚类检索)负责从海量候选中做注释、排序、去重与“相似却陌生”的识别,从而把有限的实验资源集中到更可能成功的候选上。它加速流程,但并未替代湿实验。
5. 未培养微生物发现的酶能直接用吗?
不能直接假定可用。序列命中只是起点,通常还需完成基因合成、表达、活性与稳定性测定、放大发酵等验证;未经实测的活性/动力学/稳定性数值属于预测,应以实测为准。
6. MatwingsVenus®(晓鹜®)能帮我做什么?
它可以承接从“序列到可用酶”的多个环节——AI 挖酶与设计、对话式任务调度、自动化湿实验验证与专家协同,形成可迭代的干湿闭环。具体能力与可用服务范围可咨询平台。
七、总结
未培养微生物酶发现,本质上是把“能看到却养不出来”的微生物基因,变成“可预测、可验证、可量产”的工业酶。宏基因组测序提供了原料,AI 提供了“阅读理解”,湿实验与工艺提供了“最后一公里”。当三者形成闭环,来自环境 DNA 的酶,就能更快地走进生物制造、医药、食品与材料的世界。
