
结构约束蛋白质设计:把3D结构写进AI,让蛋白更稳、更可表达
发布于 2026年10月26日
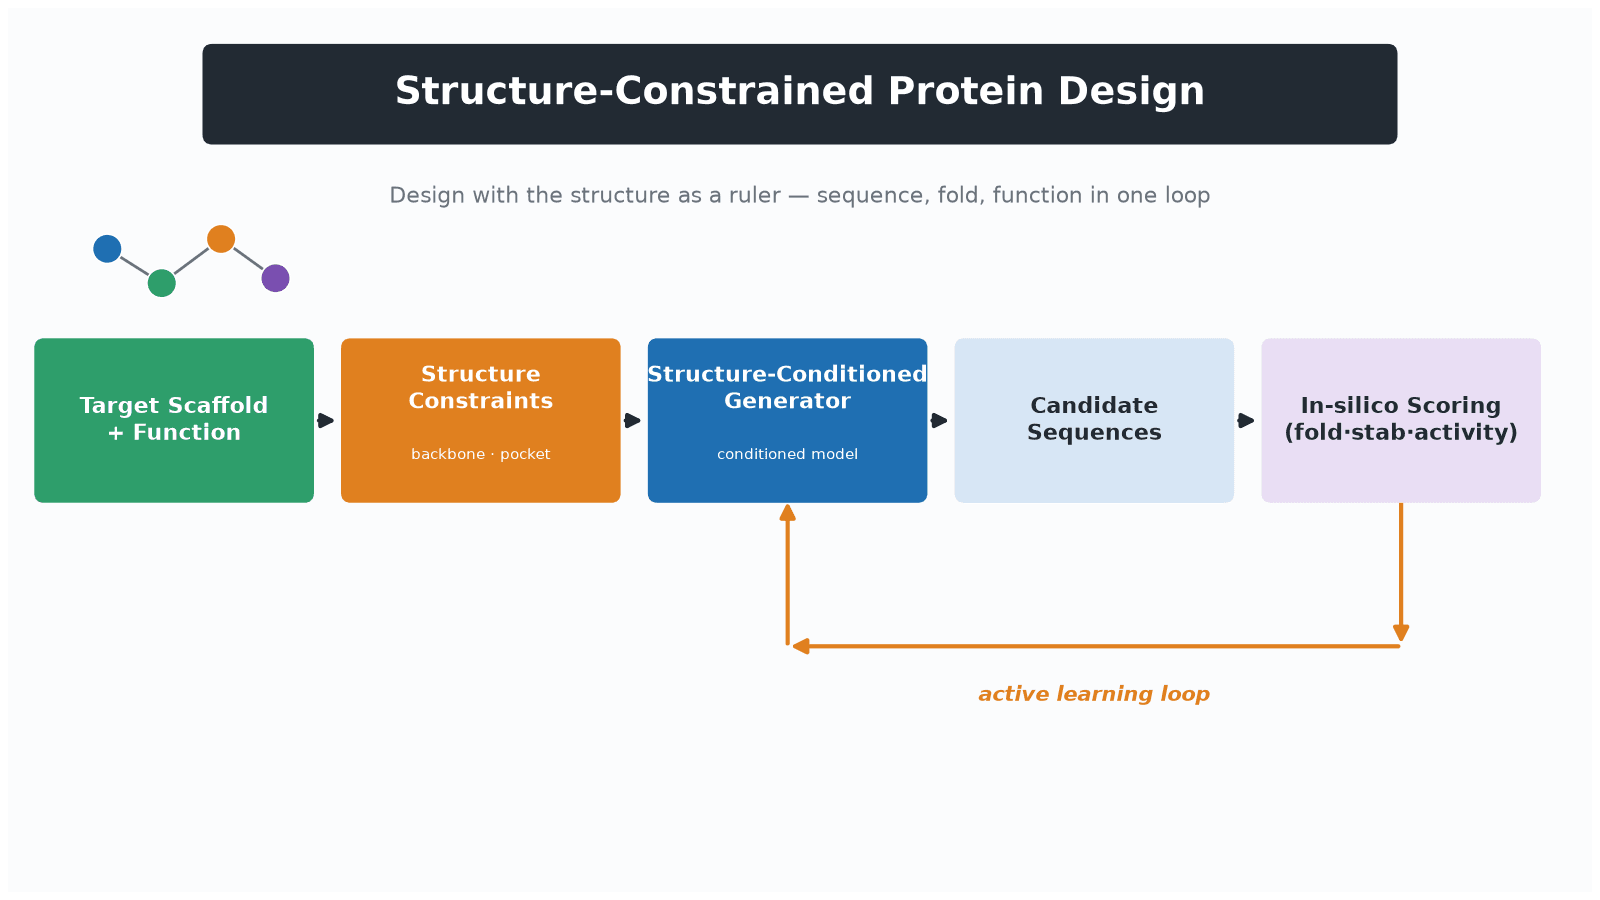
图1结构约束蛋白质设计概念全景
分类:主类D(AI/算法/平台:概念科普+能力边界);跨类C(定向进化/蛋白工程)、E(结构/机制/序列分析)
结构约束蛋白质设计:为什么「看结构」比「只看序列」更靠谱?
蛋白质是生命活动的执行者,它的功能由三维结构决定,而三维结构又由氨基酸序列折叠而来。传统的AI蛋白设计常从“序列相似性”出发,但序列相似并不等于结构相似,更不等于功能相同。于是,一种更“较真”的思路出现了——把结构本身作为约束写进设计流程,这就是结构约束蛋白质设计。
背景与挑战:为什么蛋白质设计离不开「结构」?
蛋白质的功能由三维结构决定,而三维结构又由氨基酸序列折叠而来;只靠序列相似性设计新蛋白,常常得到“能写却不能折叠、能算却不能表达”的候选。结构约束蛋白质设计正是把“结构”这把尺子放回生成过程,让算法在写序列时同时满足折叠与功能约束。
· 序列≠结构≠功能:序列决定折叠,折叠决定功能。只优化序列,容易在序列空间里“自嗨”,却忽略能否真正折叠。
· 结构的稀缺与可预测:高质量实验结构有限,但AI结构预测(如AlphaFold类模型)让“近似结构”变得廉价,为设计提供了可用的“模板”。
· 约束的价值:把骨架、口袋、界面等信息作为“约束”,等于给算法划定“合规区”,把海量序列压缩到更可能折叠、更有功能的区域。
· 可开发性不是事后补丁:结构约束从一开始就关注骨架稳定性与表面性质,减少后续“能表达但易聚集、易降解”的返工。
更现实的问题是:许多目标蛋白并没有“高相似”的天然模板。例如想要设计一个催化新反应、或结合新靶点的蛋白,序列层面几乎没有先例可循;此时仅靠序列相似性会完全失效,必须依赖“结构”这一更稳定的约束来锚定折叠骨架。
类比:结构像“蓝图”,序列像“建材”。只看建材(序列)不看蓝图(结构),盖出来的楼很可能立不起来。
原理与结构:结构约束如何「卡住」设计空间?
结构约束蛋白质设计的核心,是把已知或预测的结构信息编码成生成条件,使模型每一步都“记住”目标骨架,从而显著缩小搜索空间、提高成功率;它通常通过骨架坐标、残基距离/接触图、二级结构以及口袋/界面残基等约束来实现。

图2从结构到约束、再到序列的机制
· 约束从哪来:三类输入——实验结构(X射线/冷冻电镜)、同源建模、AI预测结构。
· 怎么用:把结构作为“条件”,做反向折叠(inverse folding),即给定骨架、反推序列。
· 约束的类型:骨架坐标、Cα距离/接触图、二面角(φ/ψ)、二级结构、口袋残基、界面残基。
· 约束注入位置:损失函数、注意力掩码、几何等变网络。
· 在抗体/VHH场景:框架区骨架稳定,CDR序列“焊”到骨架上,兼顾亲和力与可开发性。
以“反向折叠”为例,它是结构约束设计最典型的形式:给定一段经过验证或预测的骨架,模型逐位推断最可能稳定折叠、并保持特定界面与口袋的氨基酸。相比无约束生成,反向折叠把“能否折叠”变成了模型的先验条件,而不是事后才去检验的结果。
需要说明的是,结构约束并不是“越强越好”。约束过强会把设计空间卡死,导致候选高度同质化;约束过弱又会回到“只像序列”的老路。好的做法是分级约束:骨架与关键口袋作为硬约束,柔性区域作为软约束,并在二者之间留出多样性空间。
测定与选型:如何判断一次设计「成没成」?
判断结构约束设计是否成功,需要同时看“结构层”与“功能层”:确认序列能在目标骨架上正确折叠、稳定表达,再看预测活性是否被保留;常用指标包括预测与目标结构的结构一致性、表达量与可溶性、热稳定性(Tm)与结合亲和力或酶活。
· 结构验证:预测结构与目标骨架的RMSD、pLDDT、接触图谱一致性。
· 表达与可溶性:SDS-PAGE、SEC、可溶表达量。
· 稳定性:Tm(热熔温度)、DSC、加速稳定性、聚体比例。
· 功能/活性:酶活、结合亲和力(BLI/SPR)、细胞或功能实验。
· 区分类型:计算指标为【预测】,湿实验为【实测】;两者不能互相替代。
不同场景下,选型重点并不相同:若目标是工业酶,通常优先看温度、pH、底物耐受与稳定性;若目标是抗体或生物药,则优先看亲和力、特异性、可开发性与免疫原性。因此,一个“通过设计”的候选,还需要与目标应用真正匹配。
另一个容易被忽略的维度是“可复现性”。一条序列是否值得推进,不只看一次测得的活性高低,还要看它在不同批次、不同表达规模下是否稳定可重复;这在工业或临床转化阶段尤为关键。
条件与工艺:从序列到可交付蛋白的干湿闭环
结构约束蛋白质设计不是“一键出结果”,而是“设计—筛选—分析—再设计”的干湿闭环:先用结构约束批量生成候选并计算打分,再用湿实验验证表达、纯化与活性,把实测数据回灌模型,形成可迭代的工艺。

图3 结构约束设计的干湿闭环工艺流程
· 第一步:定目标——明确目标骨架、功能与不可违背的约束(如催化口袋、结合界面)。
· 第二步:AI 批量设计——一次生成成百上千个候选。
· 第三步:计算打分——按折叠、稳定性、活性多维排序。
· 第四步:湿实验验证——表达宿主、诱导、纯化、活性测定。
· 第五步:数据回流——实测结果回灌,主动学习再迭代。
工艺关键:表达系统选择、纯化工艺、可开发性(稳定性、聚体、溶解度、免疫原性)评估。
一个常见误区是“重设计、轻验证”。结构约束虽能压缩搜索空间,但真正的成功率仍然取决于湿实验能否快速、低成本地读取表达与活性。因此,闭环中的“验证环节”往往决定整体效率——设计再漂亮,若验证跟不上去,也无法形成可迭代的工艺。
此外,结构约束设计尤其适合“经验优先、改进已知”的场景:在已有天然蛋白或已验证抗体基础上做局部优化,比从零设计更容易成功;这也是大多数项目优先采用的稳妥路径。
MatwingsVenus®(晓鹜®)如何把结构约束落到可交付蛋白?
MatwingsVenus®(晓鹜®)把结构约束蛋白质设计、序列生成与湿实验验证整合为一个干湿闭环平台,让结构信息不只停留在计算层,而是与实测数据互相校准,把设计成功率变成可度量的工程指标。
· 平台能力:整合结构预测、序列设计与功能/稳定性预测能力(如VenusX、VenusG),通过单点扫描(VenusREM)、多点上位效应建模(VenusPrime)等形成可解释的优化路径。
· 干湿闭环:把计算设计结果交给湿实验验证,再把实测数据喂回模型,减少无效迭代。【实测/预测/未知】三类数据在流程中被明确区分。
· 应用场景:抗体人源化与亲和力成熟、酶工程、单域抗体(VHH)等,让结构约束真正落地到可交付序列。
对用户而言,价值不只是“拿到更多候选”,更是“更快识别出真正可交付的那一条”:平台把结构约束、打分与实测打通,减少试错轮次,把人力与材料投入集中到更可能成功的路径上。
这也意味着,结构约束设计的最终衡量标准不是“一次生成了多少条”,而是“最终有多少条在湿实验里真正达标”。在这一点上,干湿闭环让设计成功率成为可被持续改进的工程指标,而非一次性的运气。
常见问题(FAQ)
结构约束蛋白质设计与普通AI序列生成有什么不同?
普通AI序列生成多以序列相似性/语言模型为依据;结构约束设计在生成时会额外“看”结构,把骨架、口袋、界面等约束写进条件,让输出更可能正确折叠并保留功能。差异在于是否把“结构”作为硬约束。
结构约束设计能保证蛋白一定可折叠吗?
不能保证。结构约束显著提高“可折叠、可表达”的概率,但折叠还受表达系统、翻译后修饰、聚集等因素影响;最终仍以湿实验【实测】为准,计算层面只是【预测】。
计算设计的结果还需要湿实验验证吗?
需要。计算能快速排序候选、提示瓶颈,但无法替代真实的表达与活性测定;可靠做法是干湿闭环:计算筛查、湿实验确证、实测数据回流再优化。
这种设计主要用在哪些场景?
常见于抗体工程(人源化、亲和力成熟)、酶工程(活性/稳定性优化)、单域抗体(VHH)与新型结合蛋白设计,也用于需要稳定折叠与良好可开发性的工业酶或生物药候选。
总结
结构约束蛋白质设计把“结构”变成可量化的设计约束,让AI生成的序列从“看起来像”走向“真正能折叠、能表达、能干活”。它不取代湿实验,而是与湿实验组成干湿闭环,共同提升设计成功率。
一句话结论:结构约束蛋白质设计把结构当作“尺子”约束AI生成序列,让设计更可折叠、更稳定、更可表达。
— — — — — — — — — — — —
探索 MatwingsVenus®(晓鹜®)
想知道结构约束蛋白质设计如何服务于你的项目?
· 获取选型建议 / 提交样品/ 获取报价13061973951:电话 ,邮箱 info@matwings.com
· 了解干湿闭环平台
· 湿实验验证与表征:
· 专家咨询中心:
